
 Par Tsuky
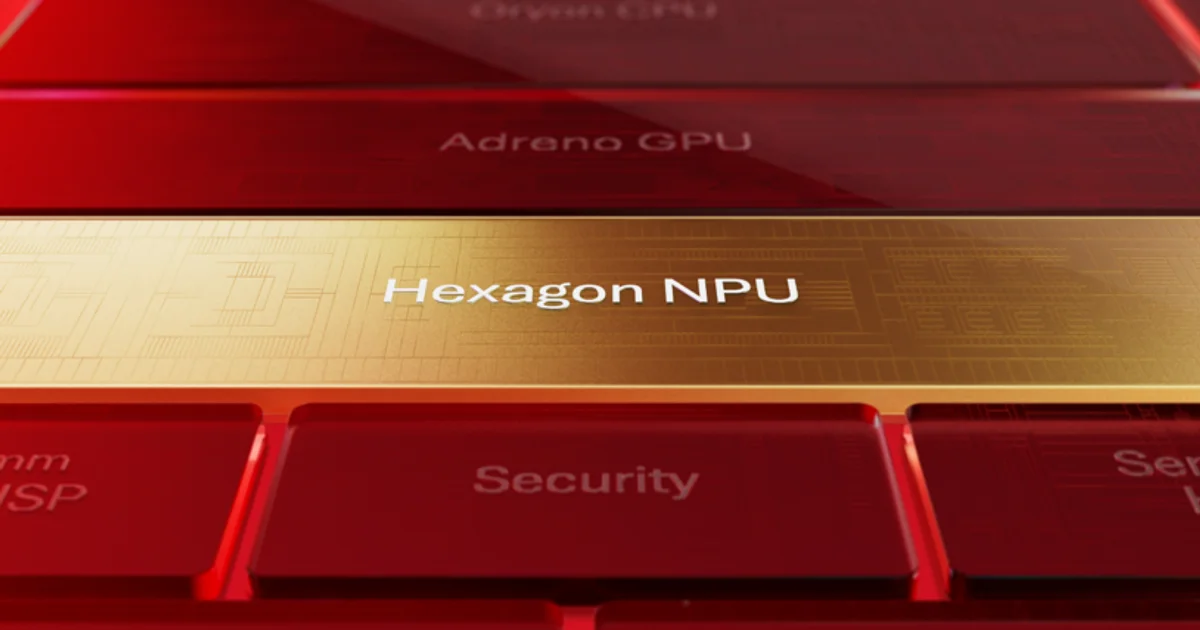
Qualcomm a dévoilé le 10 septembre une première partie de l'architecture de son prochain Hexagon NPU, destiné à sa future plateforme mobile premium.
Le constructeur ne donne pas encore le nom commercial complet du SoC et garde une partie des caractéristiques pour le Snapdragon Summit 2026. Il détaille en revanche très clairement ce qu'il veut optimiser : les agents IA exécutés directement sur l'appareil.
Deux modifications dominent cette architecture. Un nouvel Element Accelerator vient compléter les unités vectorielles, matricielles et scalaires du NPU, tandis que la capacité de mémoire partagée augmente de 50 %.
Un agent IA ne ressemble pas beaucoup à une simple question envoyée à un chatbot
Le mot « agent » est utilisé à toutes les sauces en 2026, mais le problème matériel derrière lui est assez concret.
Un assistant traditionnel reçoit une demande, génère une réponse et peut ensuite attendre tranquillement. Un agent plus ambitieux doit conserver un contexte, déterminer les étapes nécessaires, sélectionner des outils, éventuellement analyser une image ou de l'audio, exécuter une action puis revenir sur son propre résultat.
Certaines de ces tâches peuvent en outre se dérouler en parallèle.
Qualcomm parle ainsi d'IA persistante, de raisonnement sur de longs contextes, de modèles multimodaux, d'agents concurrents et de boucles d'action à faible latence.
Autrement dit, le téléphone ne doit plus seulement produire quelques tokens rapidement. Il doit être capable de maintenir plusieurs états actifs sans vider sa batterie ni passer son temps à déplacer des données entre les différentes mémoires.
L'Element Accelerator vise directement les Transformers
Le nouvel Element Accelerator est présenté comme une unité spécialisée dans les opérations utilisées par les architectures Transformer qui dominent aujourd'hui l'IA générative.
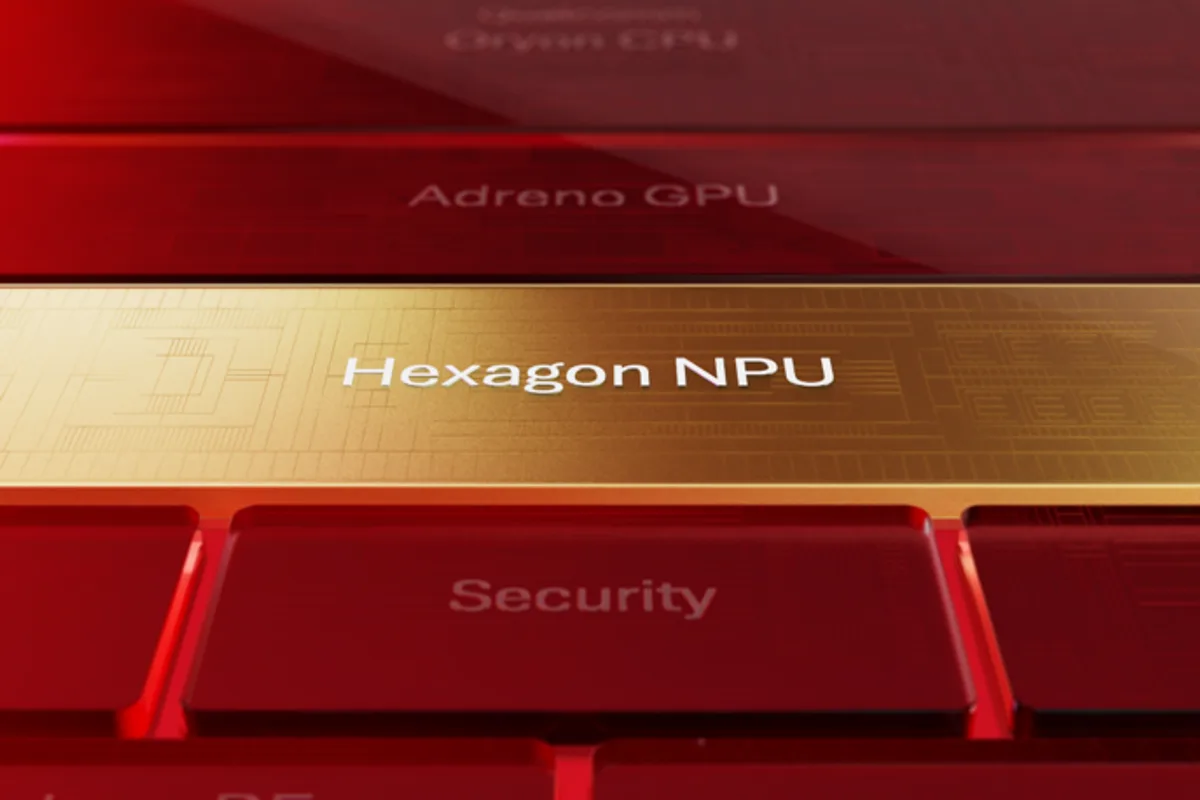
Il ne remplace pas les autres moteurs du Hexagon NPU.
Qualcomm décrit plutôt un ensemble dans lequel les extensions matricielles gèrent le calcul dense, les unités vectorielles les opérations à haut débit, les unités scalaires la logique et l'orchestration, et l'Element Accelerator certaines opérations particulièrement importantes pour les Transformers.
Cette spécialisation est une réponse assez logique à l'évolution du logiciel. Les premiers NPU mobiles étaient surtout mis en avant pour la photographie computationnelle, la reconnaissance vocale ou des réseaux relativement compacts. Ils doivent maintenant exécuter des architectures dont le profil mémoire et les opérations n'ont plus grand-chose à voir avec ces premières charges.
Les 50 % de mémoire partagée supplémentaire sont probablement plus importants que le nom du nouvel accélérateur
Qualcomm augmente de 50 % la grande mémoire partagée accessible au NPU.
Cette mémoire peut conserver davantage d'état du modèle, d'activations et de tenseurs intermédiaires directement près des unités de calcul.
Chaque donnée qui peut y rester évite potentiellement un aller-retour vers la mémoire DDR principale du téléphone.
C'est important pour la vitesse, mais aussi pour l'énergie.
Déplacer des données coûte. Sur une machine de bureau alimentée par le secteur, cette contrainte peut être absorbée par une consommation plus élevée et davantage de refroidissement. Dans un smartphone de quelques millimètres d'épaisseur, chaque accès mémoire supplémentaire finit par se retrouver quelque part entre l'autonomie et la température du châssis.
Le prochain Hexagon essaie donc de résoudre une partie du problème en rapprochant le contexte du calcul plutôt qu'en augmentant uniquement la vitesse des unités arithmétiques.
La RAM du téléphone reste néanmoins bien là
Cinquante pour cent de mémoire NPU supplémentaire ne signifie évidemment pas qu'un téléphone n'a plus besoin de beaucoup de RAM.
La mémoire partagée du NPU sert à conserver les données les plus utiles près des accélérateurs. Un grand modèle, son contexte, le système Android et les autres applications continuent de se partager des ressources beaucoup plus larges.
Qualcomm ne donne d'ailleurs pas encore la capacité absolue de cette mémoire locale.
Le constructeur explique surtout vouloir réduire la fréquence des accès à la DDR.
C'est une nuance importante dans une période où les fonctions IA sont régulièrement utilisées pour justifier des smartphones dotés de 16 Go, voire davantage, de mémoire système. Un meilleur NPU peut réduire la pression, pas faire disparaître tous les besoins.
Les modèles Mixture-of-Experts sont la seconde moitié de la stratégie
Le matériel seul ne suffit pas à faire tenir des modèles beaucoup plus gros dans un téléphone.
Qualcomm mise donc aussi sur les architectures Mixture-of-Experts, ou MoE.
Au lieu d'activer la totalité du réseau pour chaque token, un modèle MoE contient plusieurs groupes spécialisés et route chaque demande vers une partie seulement d'entre eux.
Qualcomm prend l'exemple d'un modèle disposant de 30 milliards de paramètres au total mais n'en activant qu'environ 3 milliards à chaque étape de génération.
Le modèle conserve ainsi une capacité globale beaucoup plus grande que le sous-ensemble réellement calculé pour un token donné.
La différence est essentielle pour un appareil limité en puissance. Trente milliards de paramètres actifs en permanence et trente milliards disponibles dont trois milliards seulement travaillent à un instant donné ne produisent absolument pas la même facture énergétique.
Le problème devient alors de déplacer les bons experts au bon moment
Les MoE ne suppriment pas magiquement les paramètres inutilisés.
Il faut encore les stocker quelque part et rendre disponibles les experts nécessaires lorsque le routeur décide de les activer.
Qualcomm évoque donc une gestion intelligente entre la mémoire flash et la mémoire vive, accompagnée de mécanismes de cache.
Une partie des experts peut rester dans le stockage et être transférée lorsque nécessaire au lieu d'occuper en permanence la RAM la plus rapide.
Ce système peut réduire les besoins mémoire, mais il ajoute une nouvelle contrainte : si les transferts ne sont pas anticipés correctement, l'agent attend simplement que les données arrivent.
La qualité de l'expérience dépendra donc autant du système de routage et de cache que du nombre de milliards de paramètres indiqué sur une fiche technique.
INT2 à FP16 : le même NPU doit accepter plusieurs compromis
Le prochain Hexagon prend en charge INT2, INT4, INT8, FP8 et FP16.
Ces formats permettent aux développeurs de choisir différents compromis entre précision numérique, consommation de mémoire, débit et qualité du modèle.
Une quantification INT4 stocke et manipule beaucoup moins d'information par valeur qu'un FP16. Elle réduit donc fortement le poids du modèle et la bande passante nécessaire, au prix d'une précision numérique inférieure.
Cela ne signifie pas automatiquement que la réponse finale devient quatre fois moins bonne. Les modèles modernes peuvent être entraînés ou quantifiés pour conserver une grande partie de leurs capacités avec des précisions réduites sur certaines opérations.
Il faut en revanche éviter de comparer deux NPU uniquement à partir d'un chiffre de performance obtenu dans des formats différents.
Le fameux +50 % concerne le prefill INT4, pas toutes les performances IA
Qualcomm annonce jusqu'à 50 % de performances supplémentaires pendant la phase de prefill des modèles INT4.
Cette formulation mérite d'être conservée telle quelle.
Le prefill correspond au traitement initial du contexte envoyé au modèle avant la génération des nouveaux tokens. Une amélioration de cette étape peut réduire sensiblement l'attente lorsque l'on soumet une longue conversation, un gros document ou beaucoup de contexte à un agent.
Ce n'est pas un gain général de 50 % sur toutes les charges IA.
Qualcomm mentionne séparément un décodage plus rapide, davantage de tokens par seconde et une amélioration du speculative decoding, mais sans transformer ces éléments en un unique chiffre universel.
La différence compte lorsque les futurs smartphones commenceront inévitablement à afficher « 50 % faster AI » dans des présentations beaucoup moins prudentes.
Le CPU reste nécessaire parce qu'un agent doit décider quoi faire
Le NPU accélère les modèles, mais Qualcomm ne prétend pas qu'il exécute seul toute la logique d'un agent.
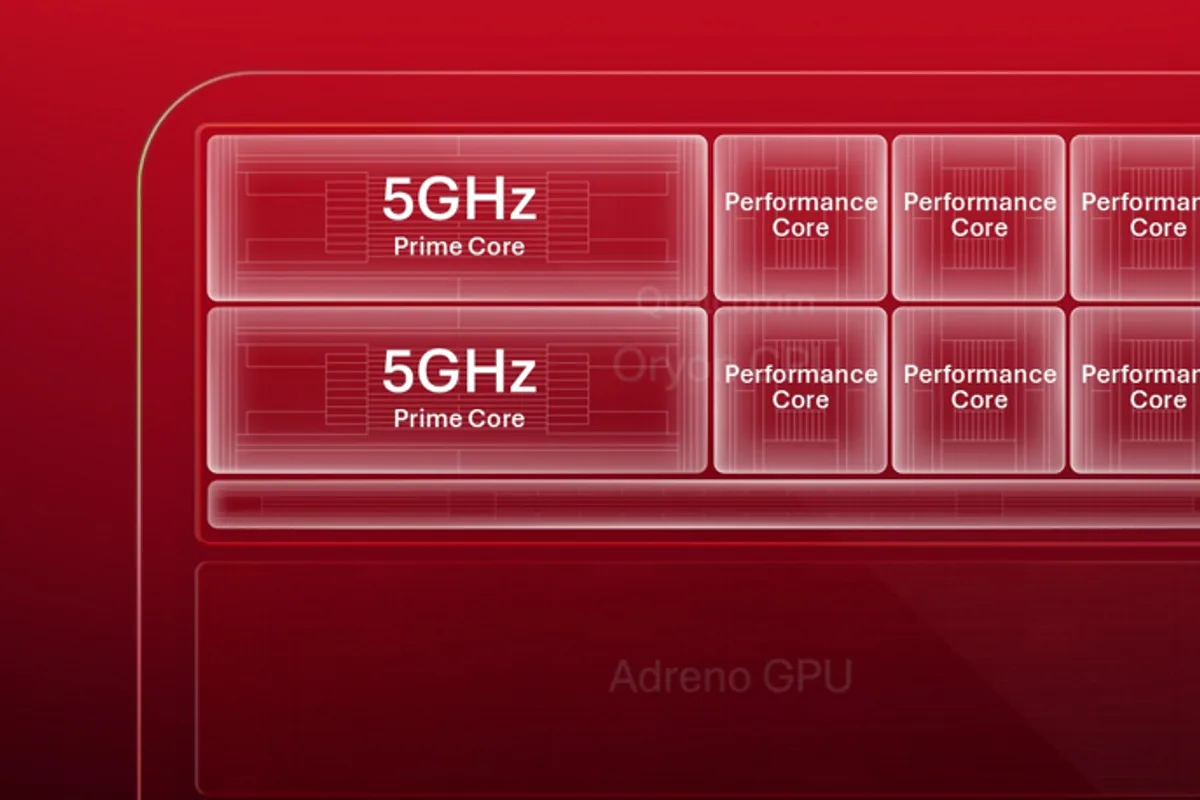
Le prochain Oryon CPU doit assurer une partie de l'orchestration : planification des tâches, appels d'outils, déplacement du travail entre unités et préparation des données nécessaires au NPU.
Qualcomm a déjà annoncé que cette génération d'Oryon atteindrait 5 GHz sur ses cœurs Prime et introduirait Flex Cache, une réserve de cache pouvant être allouée dynamiquement entre différents cœurs.
La logique générale est la même que pour le NPU : réduire les excursions vers la mémoire principale.
Un agent qui ouvre une application, récupère une information, exécute un modèle puis déclenche une autre action est par définition un workload qui traverse plusieurs composants.
La bataille ne consiste donc plus à savoir quel bloc possède le plus gros chiffre isolé. Il faut que CPU, NPU, GPU, mémoire et système d'exploitation cessent de se faire attendre mutuellement.
Le premier avantage concret du local reste la latence
Un agent exécuté sur l'appareil n'a pas besoin d'envoyer chaque étape jusqu'à un datacenter puis d'attendre le retour réseau.
Pour une action courte — reformuler une notification, comprendre une commande, extraire une donnée affichée à l'écran — quelques centaines de millisecondes économisées peuvent faire la différence entre une fonction qui semble intégrée au téléphone et une fonction qui ressemble à une page web déguisée.
Cette latence devient encore plus importante lorsqu'un workflow contient cinq ou dix étapes.
Une petite attente répétée après chaque appel finit très vite par devenir une grosse attente.
La confidentialité est l'autre argument, mais elle dépendra du logiciel
Garder l'inférence sur le smartphone peut également limiter les données envoyées vers un serveur.
Un agent capable de lire des notifications, des rendez-vous, des messages ou le contenu d'une application manipule précisément le genre d'informations que certains utilisateurs préfèrent ne pas expédier dans le cloud à chaque action.
Le mot important reste « peut ».
La présence d'un NPU suffisamment rapide ne garantit pas qu'une fonction commerciale fonctionne intégralement en local. Un constructeur peut toujours choisir d'envoyer certaines requêtes vers ses serveurs pour obtenir un modèle plus puissant, synchroniser des services ou collecter les données nécessaires à son produit.
Le hardware ouvre la possibilité d'une IA privée. Les politiques du fabricant du téléphone et du fournisseur du modèle déterminent si cette possibilité est réellement utilisée.
Un modèle de 30 milliards de paramètres sur téléphone ne signifie pas un équivalent direct des meilleurs modèles cloud
Le chiffre choisi par Qualcomm risque aussi de produire quelques raccourcis.
Un MoE de 30 milliards de paramètres dont environ 3 milliards sont actifs par token n'est pas directement comparable à un modèle dense de 30 milliards.
Le nombre total de paramètres ne mesure pas à lui seul la qualité du raisonnement, la connaissance, la longueur de contexte utile ou la fiabilité d'un agent.
L'intérêt technique se trouve ailleurs : une architecture MoE permet de mettre à disposition davantage de spécialités tout en gardant le calcul actif à une taille compatible avec une enveloppe mobile.
Cela pourrait parfaitement suffire pour des agents spécialisés — calendrier, recherche locale, traitement de documents, photo, traduction, commandes système — sans chercher à reproduire intégralement un modèle frontier de datacenter.
Le smartphone pourrait devenir une petite équipe de modèles plutôt qu'un seul cerveau
Qualcomm affirme d'ailleurs que l'avenir agentique ne reposera pas forcément sur un modèle gigantesque chargé de tout faire.
Le constructeur imagine plusieurs modèles spécialisés sélectionnés en fonction de la tâche, du contexte et de l'utilisateur.
Un modèle compact peut traiter une commande locale. Un autre peut comprendre l'image de la caméra. Un routeur peut décider qu'une requête complexe exige un modèle plus important ou un appel cloud.
C'est probablement une architecture beaucoup plus réaliste pour un smartphone qu'un unique LLM occupant en permanence toute la mémoire disponible.
Elle est aussi beaucoup plus compliquée à rendre invisible pour l'utilisateur.
Si le système choisit régulièrement le mauvais modèle, perd le contexte entre deux outils ou demande une confirmation à chaque étape, l'agent sera techniquement impressionnant et pratiquement fatigant.
Il reste énormément de choses que Qualcomm n'a pas encore chiffrées
Qualcomm n'a pas encore communiqué la capacité absolue de la mémoire partagée du NPU, sa bande passante, sa consommation dans les charges agentiques longues ni le nombre précis d'opérations par seconde de la nouvelle génération.
On ne connaît pas non plus les performances soutenues après plusieurs minutes d'inférence continue dans un téléphone commercial.
Ce dernier point sera particulièrement important.
Un benchmark court peut laisser un SoC utiliser une enveloppe thermique agressive. Un agent permanent doit fonctionner toute la journée sans transformer chaque tâche de calendrier en test de chauffe.
Les chiffres présentés au Snapdragon Summit devront donc être lus avec les mêmes questions que pour un CPU ou un GPU : puissance de pointe, oui, mais à quelle consommation et pendant combien de temps ?
La prochaine bataille mobile pourrait finalement se jouer autour de la mémoire
Le nouvel Element Accelerator est la nouveauté qui porte le nom le plus facile à retenir.
La hausse de 50 % de la mémoire partagée explique peut-être mieux ce qui change réellement.
L'IA mobile atteint une étape où ajouter du calcul ne suffit plus. Les modèles manipulent davantage de contexte, plusieurs outils restent ouverts et les agents doivent conserver assez d'état pour ne pas recommencer leur raisonnement à chaque interaction.
Qualcomm essaie donc de garder davantage de données près des unités qui les utilisent, de n'activer qu'une fraction des modèles lorsqu'une fraction suffit et de réduire le recours à la mémoire externe.
Le Snapdragon Summit dira combien de silicium et de watts sont nécessaires pour y parvenir.
La vraie démonstration viendra ensuite dans les téléphones : un agent local ne sera convaincant que lorsqu'il pourra rester utile toute la journée sans que l'utilisateur commence à chercher une prise avant lui.