
 Par Tsuky
Un chatbot reçoit une question et renvoie une réponse. Un agent chargé d'enquêter sur une panne, modifier un dépôt ou produire une analyse complète peut enchaîner des dizaines d'actions, utiliser plusieurs outils, créer des fichiers, perdre une partie de son contexte, rencontrer une erreur puis devoir reprendre là où il s'était arrêté.
C'est précisément la couche qu'OpenAI veut maintenant vendre comme infrastructure.
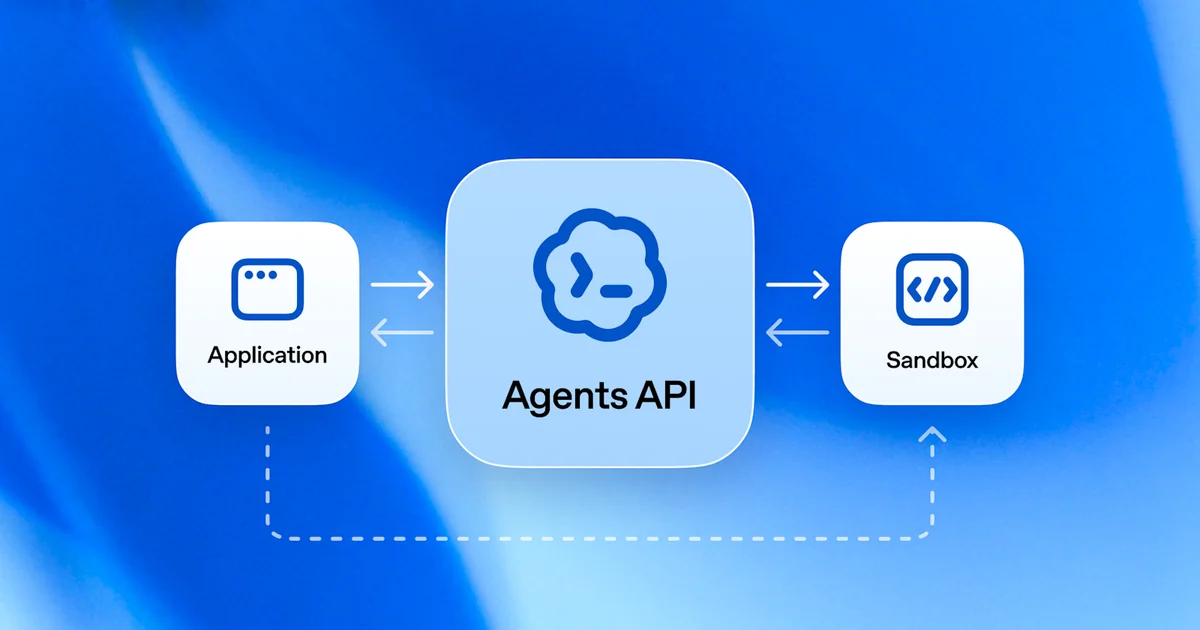
L'Agents API, disponible en bêta publique depuis le 10 septembre, expose aux développeurs le harness utilisé derrière Codex. Avec un appel d'API, ils peuvent définir une tâche, choisir un modèle, lui donner des outils et décider où le travail sera exécuté.
Le modèle n'est plus toute l'histoire
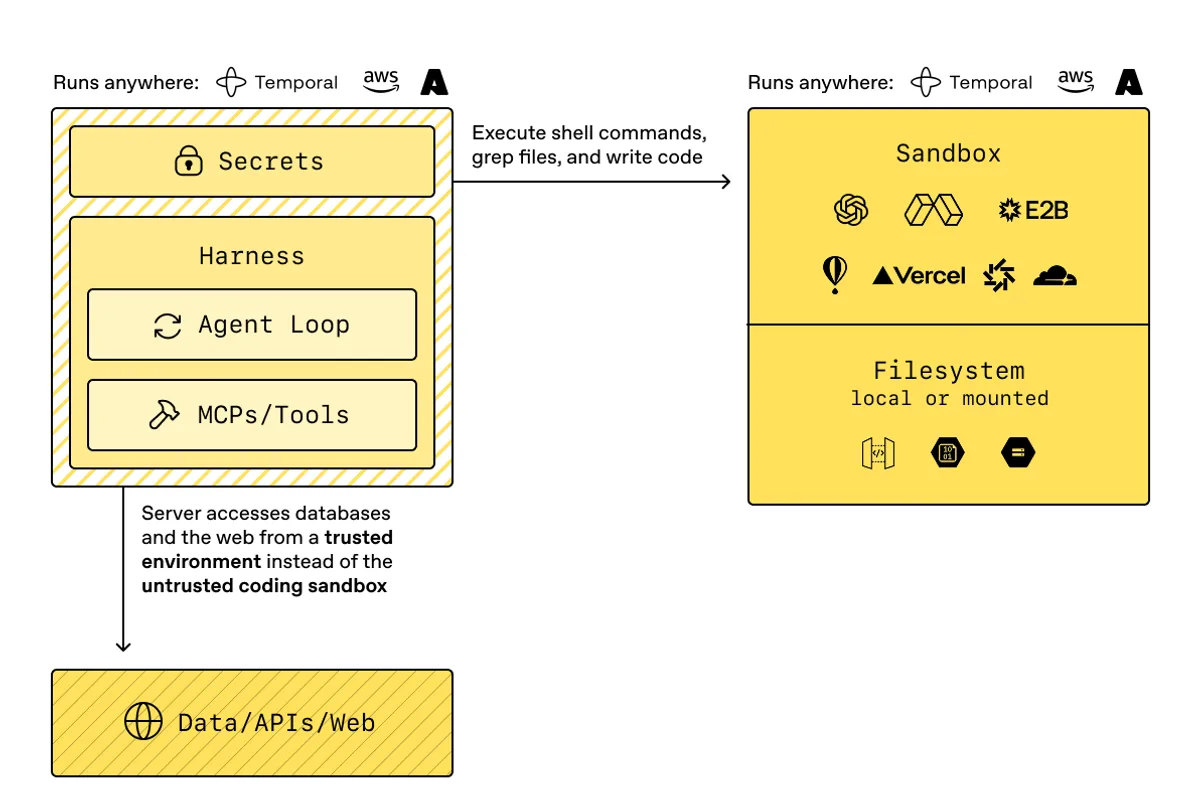
OpenAI appelle cette couche le harness. Elle orchestre les appels au modèle, conserve l'état de la session, gère les outils et peut coordonner plusieurs sous-agents.
C'est moins spectaculaire qu'un nouveau score de benchmark, mais beaucoup plus proche des problèmes rencontrés lorsqu'un agent quitte une démo de cinq minutes pour entrer dans un vrai workflow.
Un agent qui travaille longtemps finit notamment par approcher la limite de son contexte. Agents API peut alors compacter automatiquement les échanges précédents pour conserver les informations jugées utiles et poursuivre la session au-delà d'une seule fenêtre de contexte.
Les sessions sont durables. OpenAI indique que l'infrastructure est pensée pour des travaux qui peuvent se prolonger pendant des heures, voire des jours.
Les sous-agents peuvent travailler en parallèle
La nouvelle API intègre aussi un mode multi-agent. Un agent principal peut déléguer différentes parties d'un problème à plusieurs sous-agents, attendre leurs résultats puis les intégrer dans son propre travail.
L'exemple fourni par OpenAI est assez parlant : enquêter sur une hausse d'erreurs serveur en demandant simultanément à plusieurs sous-agents d'examiner les déploiements, les erreurs et les dépendances.
Le développeur peut définir le nombre maximal de sous-agents travaillant en parallèle. L'API expose également leurs sessions et leurs différentes étapes, plutôt que de traiter la délégation comme une boîte noire totalement opaque.
Ce modèle ressemble davantage à un petit système distribué qu'à une conversation avec un assistant.
OpenAI veut aussi résoudre le problème des outils trop nombreux
Brancher cinq outils à un modèle est simple. Lui en décrire des centaines peut rapidement engloutir du contexte avant même que la tâche commence.
Le harness comprend donc une recherche d'outils qui charge les définitions pertinentes à la demande plutôt que d'injecter l'intégralité du catalogue dans chaque requête. OpenAI présente ce mécanisme comme un moyen de réduire la consommation de tokens tout en préservant plus efficacement le cache de prompt.
Les agents peuvent aussi appeler des outils de manière programmatique, filtrer leurs résultats en code et paralléliser certaines opérations.
C'est là que la frontière avec le chatbot devient franchement mince. La réponse en langage naturel n'est plus nécessairement le produit. Elle peut n'être que le compte rendu final d'une série d'actions.
Le bac à sable reste séparé du cerveau de l'agent
OpenAI ne force pas pour autant tout le calcul dans son propre cloud.
Le harness peut être hébergé et orchestré par OpenAI tandis que le code de l'agent s'exécute dans un environnement séparé. Le développeur peut utiliser un sandbox hébergé par OpenAI, son propre environnement ou l'un des partenaires déjà annoncés, parmi lesquels Cloudflare, DigitalOcean, E2B, Modal, Oracle, Runloop et Vercel.
Cette séparation est importante pour les entreprises. Les secrets, les connexions aux systèmes internes et certaines décisions de contrôle peuvent rester dans une couche de confiance différente de l'espace où l'agent exécute du code potentiellement imprévisible.
Dans les sandboxes gérés par OpenAI, l'agent peut exécuter du code, travailler avec des fichiers, installer des paquets et produire des artefacts.
OpenAI ne facture pas l'orchestration séparément
Agents API est ouverte à tous les développeurs pendant sa bêta publique. OpenAI indique ne pas ajouter de frais spécifiques pour l'utilisation de l'API elle-même : la facturation repose sur les tokens des modèles, les outils payants et, lorsqu'ils sont utilisés, les coûts associés aux environnements de calcul.
C'est un positionnement assez agressif.
Une partie du marché des agents s'est construite précisément autour de frameworks chargés d'orchestrer les modèles, les outils et la mémoire. OpenAI transforme désormais cette couche en service directement attaché à ses modèles.
Le vrai produit est le harness
Le mouvement est plus important qu'une nouvelle route d'API.
Pendant plusieurs années, la comparaison entre fournisseurs d'IA s'est concentrée sur le modèle : lequel raisonnait mieux, codait mieux ou coûtait moins cher par million de tokens. Les agents rendent cette comparaison incomplète.
Deux applications utilisant le même modèle peuvent avoir des performances très différentes selon la manière dont elles gèrent le contexte, choisissent leurs outils, récupèrent après une erreur ou découpent un problème entre plusieurs agents.
OpenAI l'a manifestement constaté avec Codex. Au lieu de demander à chaque développeur de reconstruire cette couche, l'entreprise la transforme désormais en produit.
Le modèle reste important. Mais avec Agents API, OpenAI commence à vendre ce qui se passe entre deux appels au modèle.