
 Par Adri
OpenAI approfondit sa coopération avec Samsung Electronics dans les semi-conducteurs.
Le 9 septembre, Harrison Kim, directeur général d'OpenAI Korea, a expliqué que les deux entreprises travaillaient notamment sur la production et la recherche de puces de prochaine génération.
Il faut immédiatement mettre une limite à cette annonce : aucun nouveau contrat de fabrication, aucune puce Samsung-OpenAI précise et aucun calendrier industriel supplémentaire n'ont été dévoilés.
Il s'agit d'une extension du travail déjà engagé entre les deux groupes, pas de l'annonce d'un nouveau processeur prêt à partir en production.
La relation avait commencé par une montagne de mémoire
Samsung et OpenAI avaient officialisé en 2025 un partenariat beaucoup plus large autour de l'infrastructure IA.
Samsung Electronics y devenait notamment partenaire mémoire stratégique du programme Stargate.
Le chiffre utilisé à l'époque donnait déjà une idée de l'échelle : OpenAI estimait que ses besoins pourraient atteindre jusqu'à 900 000 wafers DRAM par mois.
À ce niveau, le problème n'est plus simplement de négocier le prix de quelques modules HBM. Il faut sécuriser des capacités de production, du packaging, des procédés avancés et une feuille de route capable de suivre plusieurs générations d'accélérateurs.
Samsung arrive avec une HBM4 déjà en production
Le timing est plutôt favorable au constructeur coréen.
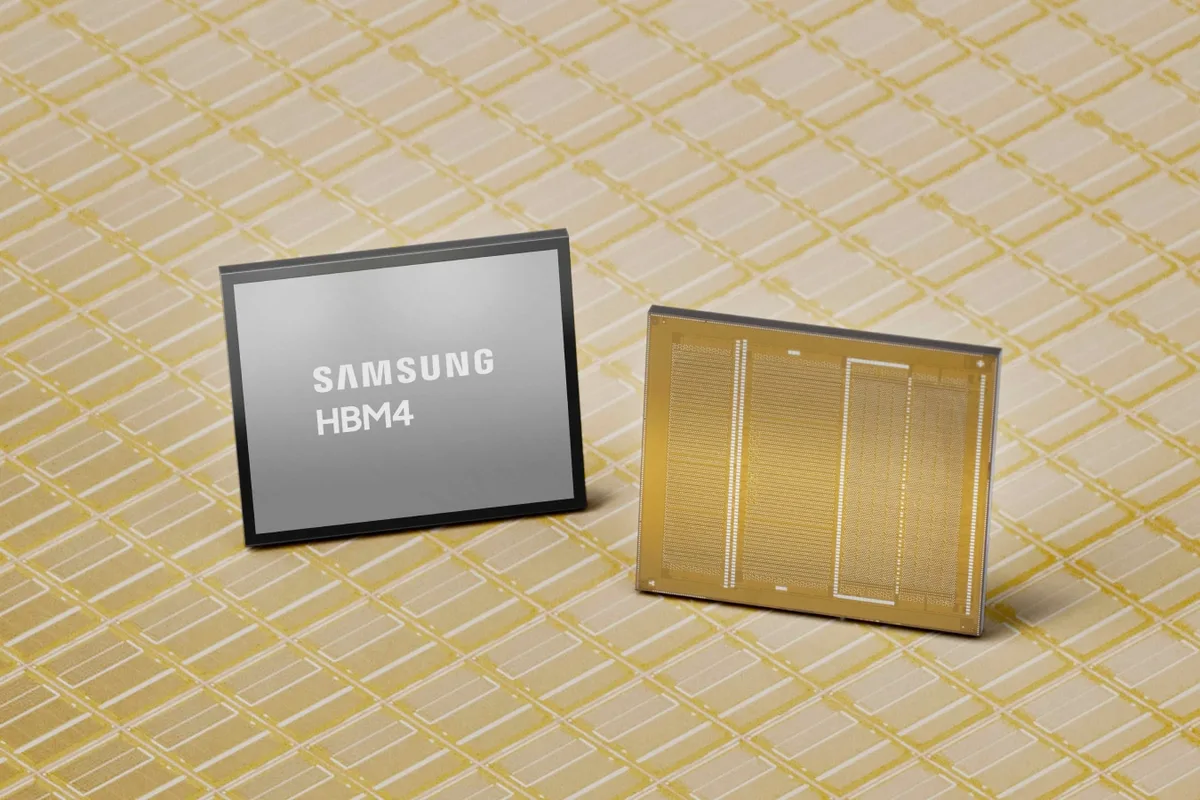
Samsung a lancé cette année la production de masse de sa HBM4 et commencé les livraisons commerciales.
La mémoire utilise une interface de 2 048 bits et atteint 11,7 Gbit/s par broche dans sa configuration annoncée, avec une marge allant jusqu'à 13 Gbit/s.
Un stack peut ainsi monter jusqu'à 3,3 To/s de bande passante mémoire.
Samsung revendique également une amélioration d'environ 40 % de l'efficacité énergétique par rapport à sa génération HBM3E, un chiffre qui prend une importance particulière lorsque des dizaines de milliers d'accélérateurs fonctionnent simultanément dans le même campus.
Les capacités vont actuellement de 24 à 36 Go par stack sur douze couches, avec des versions seize couches prévues pour atteindre 48 Go.
Mais OpenAI n'a plus seulement besoin de mémoire
Le mot important dans les déclarations du 9 septembre est « puces », pas uniquement « DRAM ».
OpenAI cherche depuis plusieurs années à réduire la dépendance d'une infrastructure IA entièrement construite autour de composants conçus par d'autres entreprises.
En juin, OpenAI et Broadcom ont présenté Jalapeño, le premier accélérateur d'inférence conçu directement autour des besoins d'OpenAI.
Broadcom participe à son industrialisation et TSMC à sa fabrication.
Cela signifie que le travail avec Samsung ne doit pas être interprété automatiquement comme le remplacement de TSMC sur Jalapeño.
OpenAI parle d'une plateforme multi-génération et les discussions avec Samsung concernent des technologies futures. Plusieurs rôles sont donc possibles : mémoire, foundry, packaging, interconnexions ou assemblage hétérogène.
Samsung possède justement presque toutes ces briques
C'est probablement ce qui rend Samsung particulièrement intéressant dans cette discussion.
Le groupe ne fabrique pas seulement de la DRAM.
Samsung Electronics regroupe sous le même toit de la mémoire avancée, une activité foundry capable de produire des puces logiques, des technologies de packaging et des solutions d'intégration entre mémoire et semiconducteurs système.
Dans une infrastructure IA moderne, ces couches sont de moins en moins indépendantes.
Un accélérateur peut avoir d'excellentes unités de calcul et perdre une partie de son avantage parce que sa mémoire n'alimente pas assez vite les données. Une très bonne mémoire devient beaucoup moins utile si le packaging augmente les distances, la consommation ou les contraintes thermiques.
Le travail intéressant se fait donc de plus en plus à l'endroit où le GPU, la HBM, les interconnexions et le package cessent d'être quatre produits séparés.
Le prochain accélérateur pourrait être conçu avec la mémoire dès le départ
C'est l'une des implications techniques les plus intéressantes de ce rapprochement.
Une entreprise qui connaît plusieurs années à l'avance les besoins d'un futur accélérateur peut adapter très tôt la mémoire et le packaging plutôt que d'assembler des composants définis séparément.
Samsung travaille déjà de cette manière avec de grands fabricants de GPU et des hyperscalers sur les ASIC de prochaine génération.
Ses futures mémoires HBM4E puis HBM5 doivent justement évoluer dans un environnement où les clients demandent de plus en plus de variantes personnalisées.
Samsung prévoit d'ailleurs de commencer l'échantillonnage de solutions HBM personnalisées en 2027 selon les spécifications de ses clients.
OpenAI fait partie du type de client qui peut justifier ce niveau de personnalisation.
La bataille avec SK Hynix ne disparaît évidemment pas
Le partenariat OpenAI ne donne pas pour autant à Samsung un monopole sur la mémoire de Stargate.
SK Hynix avait lui aussi signé pour participer à l'approvisionnement mémoire du programme.
Les deux fabricants coréens restent donc concurrents pour une demande extraordinairement importante et techniquement exigeante.
Cette concurrence est particulièrement sensible sur la HBM, devenue l'un des composants les plus contraignants de toute la chaîne d'approvisionnement IA.
Quand la capacité HBM manque, ajouter davantage de wafers logiques ne suffit pas : l'accélérateur final ne peut tout simplement pas être assemblé au rythme attendu.
OpenAI devient progressivement son propre architecte matériel
L'autre mouvement se trouve du côté d'OpenAI.
L'entreprise ne se contente plus de réserver des GPU dans le cloud.
Elle travaille maintenant directement avec des fabricants de mémoire, conçoit ses accélérateurs avec Broadcom, participe aux décisions de systèmes et construit Stargate avec plusieurs partenaires d'infrastructure.
Jalapeño a été développé jusqu'au tape-out en neuf mois selon OpenAI, avec l'aide de ses propres modèles dans le processus de conception.
Ce point est important : la société dispose désormais d'équipes qui peuvent discuter avec Samsung au niveau de l'architecture, et pas uniquement comme un client final demandant davantage de capacité.
Samsung devient en parallèle un énorme client d'OpenAI
La relation va dans les deux sens.
En juin, Samsung Electronics a commencé à déployer ChatGPT Enterprise et Codex auprès de tous ses employés en Corée ainsi qu'auprès de sa division Device eXperience dans le monde.
OpenAI décrit ce déploiement comme l'un de ses plus importants chez un client entreprise.
Samsung utilise ces outils dans le développement logiciel, la recherche, la fabrication, le marketing et plusieurs fonctions internes.
Il devient donc simultanément fournisseur d'infrastructure pour OpenAI et consommateur à grande échelle de ses modèles.
La vraie question est de savoir jusqu'où Samsung remontera dans la puce
Pour l'instant, il faut résister à la tentation de remplir les blancs.
OpenAI n'a pas annoncé que Samsung fabriquerait son prochain accélérateur. Samsung n'a pas annoncé un ASIC conçu exclusivement pour OpenAI. Aucun remplacement de Broadcom ou de TSMC n'a été officialisé.
Ce qui est confirmé est déjà suffisamment significatif.
Le partenariat parti d'une gigantesque demande en mémoire s'étend maintenant à la recherche et à la production de semi-conducteurs de prochaine génération.
Pour Samsung, la réussite consisterait à vendre à OpenAI plusieurs couches de la même machine : HBM, silicium logique, packaging et éventuellement fabrication.
Pour OpenAI, l'intérêt est l'inverse : disposer de plusieurs fournisseurs et de plusieurs chemins industriels pendant que ses propres besoins de calcul continuent de grossir.
La prochaine étape importante ne sera donc pas une nouvelle déclaration sur le partenariat. Ce sera l'apparition d'un composant précis permettant enfin de voir quelle partie de la future pile OpenAI Samsung a réellement réussi à capturer.