
 Par Tsuky
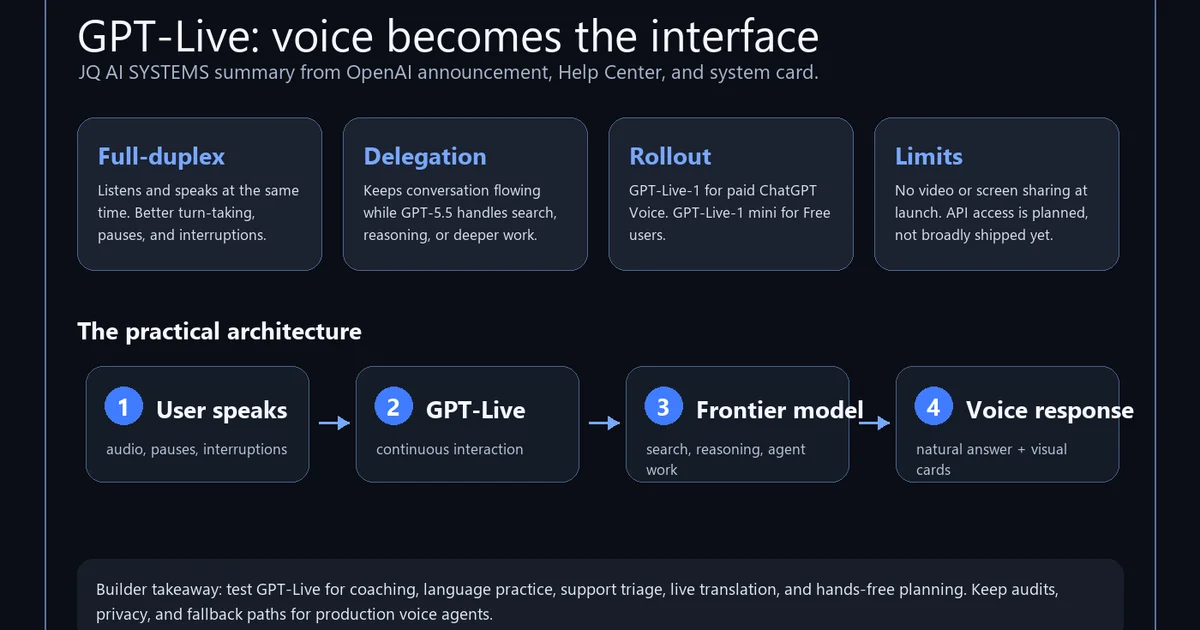
OpenAI a rendu GPT-Live-1 disponible dans son API le 10 septembre. Le modèle était déjà utilisé dans ChatGPT Voice, mais les développeurs peuvent désormais construire leurs propres applications autour de cette couche vocale full-duplex.
Full-duplex signifie ici que le modèle peut écouter et parler en même temps. L’utilisateur peut hésiter, reprendre sa phrase, intervenir pendant une réponse ou simplement laisser un silence sans que l’ensemble doive forcément retomber dans une séquence rigide « j’écoute, puis je parle ».
Le modèle vocal n’a plus besoin de faire tout le raisonnement lui-même
La nouveauté architecturale la plus intéressante est la délégation. GPT-Live-1 peut gérer la conversation immédiate puis transmettre les tâches plus lourdes à un modèle texte, un agent ou des outils externes.
OpenAI cite par exemple GPT-6 Astra pour les requêtes nécessitant davantage de raisonnement. Un développeur peut aussi utiliser un autre backend ou son propre système d’agents.
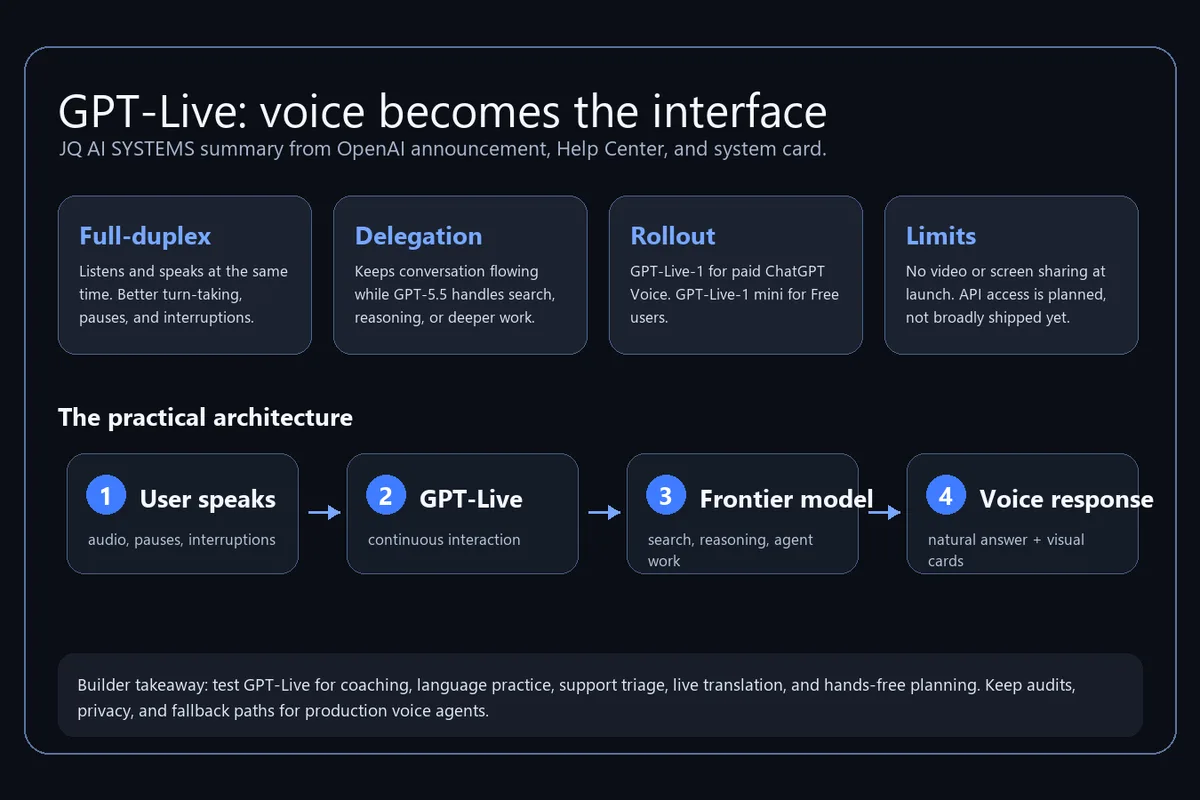
La conversation peut continuer pendant ce travail. Une interruption de la parole ne signifie d’ailleurs pas automatiquement que la tâche backend est annulée : l’application garde le contrôle de l’état durable, des permissions et de ce qui doit continuer ou s’arrêter.
C’est une différence assez importante avec un pipeline où reconnaissance vocale, LLM et synthèse sont enchaînés à chaque tour. OpenAI veut laisser GPT-Live-1 gérer le timing humain pendant qu’un autre composant gère la profondeur.
30 points de mieux sur Full Duplex Bench
OpenAI annonce une amélioration de 30 points de pourcentage sur Full Duplex Bench par rapport à GPT-Realtime-2.1. Le benchmark évalue notamment les interruptions, les pauses, les backchannels et la capacité à comprendre qu’un utilisateur n’a pas réellement terminé son tour de parole.
Avec GPT-6 Astra configuré en effort de raisonnement moyen comme backend, GPT-Live-1 atteint également 83,6 % de réussite au premier essai sur Tau3 selon les résultats publiés par OpenAI. GPT-Realtime-2.1 atteint 45,7 % dans cette comparaison.
Tau3 couvre des tâches de service client dans l’aérien, le commerce et les télécoms. Sur TauBanking, qui ajoute recherche documentaire et outils liés à des comptes bancaires, la combinaison atteint 38,1 %.
Ce dernier chiffre est un rappel utile : une conversation beaucoup plus naturelle ne transforme pas automatiquement un agent en système parfaitement fiable pour des procédures complexes.
Le tarif paraît simple, jusqu’à ce que le backend commence à travailler
OpenAI facture la couche GPT-Live-1 à 0,05 dollar par minute de session vocale. La facturation se fait à la seconde, sans arrondi obligatoire à la minute supérieure.
Une heure continue représente donc 3 dollars pour la couche vocale seule.
Le mot important est « seule ». Le modèle backend, ses tokens, les outils utilisés et les éventuels services externes sont facturés séparément. Un agent chargé uniquement de discuter n’aura donc pas le même coût qu’un assistant qui interroge des bases de données, lance du code ou délègue régulièrement à un gros modèle de raisonnement.
OpenAI vise directement les appels téléphoniques
GPT-Live-1 prend en charge les usages de téléphonie. OpenAI cite les réservations, commandes et services clients parmi les scénarios visés.
Le modèle produit nativement des transcriptions ASR et du texte de réponse, comprend mieux les chaînes alphanumériques et permet aux développeurs de biaiser la reconnaissance vers certains mots-clés. Ce dernier point peut être utile pour des noms de produits, des références ou du vocabulaire métier inhabituel.
Il prend également en charge la détection explicite des tours de parole même s’il n’est pas lui-même conçu comme un modèle strictement turn-based.
Presque 80 % d’interruptions en moins chez Speak
OpenAI publie aussi plusieurs retours d’entreprises ayant testé le modèle. Speak affirme avoir réduit de presque 80 % les interruptions pendant les pauses de réflexion de ses apprenants par rapport à ses précédents systèmes fondés sur des tours de parole.
Ce genre de mesure est plus concret qu’une démonstration où deux voix se coupent proprement. Pour un professeur de langue, savoir qu’une demi-seconde de silence signifie « je réfléchis » plutôt que « j’ai fini » change directement l’expérience.
Yelp indique de son côté utiliser GPT-Live-1 dans des flux liés aux réservations et commandes téléphoniques, tandis que Cognition l’emploie pour permettre de discuter avec Devin et de lui déléguer du travail.
Une douzaine de nouvelles voix, mais ce n’est pas le vrai changement
OpenAI élargit la bibliothèque avec Quartz, Ripple, Vesper, Willow, Stone, Gleam, Meridian, Bossa, Tempo, Beacon, Delta et Cinder. L’entreprise annonce vouloir continuer à étendre accents, dialectes et langues.
Le style, le rythme et le ton peuvent être pilotés depuis le prompt système. Des voix personnalisées existent également pour certains clients éligibles.
La liste est utile, mais elle masque presque le changement plus profond : GPT-Live-1 est désormais vendu comme une interface temps réel indépendante du moteur qui effectue le travail complexe.
À 5 cents la minute, OpenAI ne facture donc pas seulement une meilleure synthèse vocale. Il vend une couche chargée de décider quand écouter, quand parler, quand laisser respirer l’utilisateur et quand passer discrètement le problème à quelqu’un de plus costaud derrière.