
 Par Tsuky
Google a lancé Gemini 3.8 Live et Gemini 3.8 Live Extended Thinking le 15 septembre. Les deux modèles sont conçus comme des systèmes speech-to-speech natifs pour les applications vocales temps réel, plutôt que comme une simple chaîne reconnaissance vocale, modèle de langage puis synthèse vocale.
Le premier modèle cible surtout la latence, le coût et les déploiements à grande échelle. Extended Thinking est destiné aux requêtes plus difficiles, lorsque plusieurs étapes de raisonnement, des appels de fonctions ou des tâches asynchrones doivent se dérouler sans interrompre le dialogue.
L’appel d’outil ne doit plus mettre la conversation sur pause
Google introduit l’appel de fonctions asynchrone. Un agent peut lancer une API ou un outil en arrière-plan tout en continuant à produire de l’audio pour son interlocuteur.
Cela paraît presque évident lorsqu’on le décrit comme ça. Dans une architecture vocale classique, c’est pourtant une source fréquente de latence perceptible : l’assistant comprend la requête, attend le résultat externe puis recommence à parler. Ici, il peut reconnaître immédiatement la demande, poursuivre l’échange et intégrer le résultat lorsqu’il arrive.
Extended Thinking pousse ce fonctionnement plus loin. Le modèle peut raisonner sur plusieurs étapes en parallèle de la conversation et annoncer sa progression avec de courtes indications vocales pendant que le traitement continue.
97 langues peuvent être détectées au milieu d’une conversation
Gemini 3.8 Live peut détecter automatiquement les changements entre 97 langues prises en charge, y compris lorsqu’un utilisateur passe de l’une à l’autre pendant la même discussion.
Google met également en avant une meilleure précision sur les chaînes alphanumériques : codes de confirmation, numéros de dossier et données techniques. Ce genre de détail compte beaucoup plus dans un centre d’appels qu’une démonstration spectaculaire de conversation libre. Un agent qui comprend parfaitement une phrase mais transforme un numéro de contrat reste assez peu utile.
Le modèle traite aussi des entrées visuelles en quasi-temps réel. Un assistant peut donc commenter ce qu’une caméra ou un flux visuel lui montre pendant que la discussion continue.
Le modèle Extended Thinking prend la tête d’un benchmark vocal
Google annonce un score de 82,6 sur le Speech to Speech Quality Index d’Artificial Analysis pour Gemini 3.8 Live Extended Thinking. Le modèle obtient aussi 68,6 % sur τ-Voice, 35,1 % sur τ-Voice-banking et 97,7 % sur Big Bench Audio.
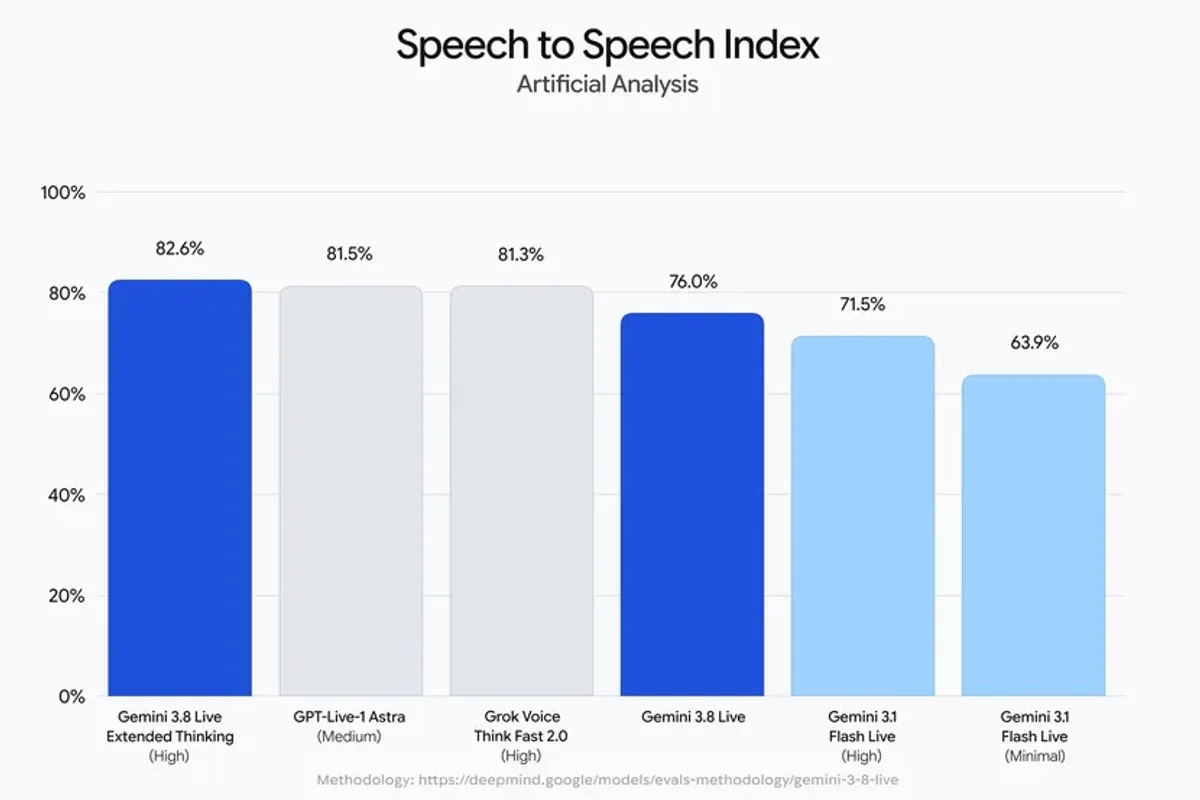
Ces chiffres ne racontent évidemment pas toute l’expérience d’un agent vocal. Le 35,1 % obtenu sur le benchmark bancaire est d’ailleurs un bon rappel : même un modèle très bien classé reste loin d’exécuter parfaitement toutes les procédures complexes d’un service client.
Gemini 3.8 Live, la variante orientée coût et volume, arrive deuxième dans Speech Agent Arena selon les résultats mis en avant par Google.
0,005 dollar la minute en entrée audio
Pour les développeurs, Google annonce un coût estimé à 0,005 dollar par minute d’audio en entrée et 0,018 dollar par minute en sortie audio. La société précise que cette estimation repose sur les tarifs de 3 dollars par million de tokens en entrée et 12 dollars par million en sortie.
Extended Thinking peut ajouter des coûts liés aux tokens de raisonnement et aux autres types d’entrées utilisés. Autrement dit, le prix d’une conversation simple et celui d’un agent qui observe une vidéo, raisonne, appelle plusieurs API et génère des résultats structurés ne seront pas vraiment comparables.
Google pousse une alternative aux pipelines vocaux en cascade
L’intérêt architectural est assez clair. Les systèmes vocaux reposant sur une succession ASR, LLM et TTS multiplient les points où de la latence peut apparaître et où les intentions peuvent se perdre entre deux composants.
Gemini 3.8 Live traite directement audio, raisonnement et production vocale dans une même famille de modèles. Google ne supprime pas pour autant tous les composants externes : outils, bases de données et API restent nécessaires pour agir. La différence est qu’ils n’ont plus besoin de suspendre toute l’interface pendant leur exécution.
Les développeurs peuvent utiliser les deux modèles dans Gemini API et Google AI Studio. Google propose aussi des intégrations via Agora, Fishjam, LiveKit, LangChain, Pipecat, Vercel et Vision Agents pour gérer la partie streaming média.
Search, Gemini Live et Workspace commencent déjà le déploiement
Gemini 3.8 Live est déployé dans Search Live et proposé en préversion privée dans Gemini Enterprise. Extended Thinking arrive dans Gemini Live et, pour les abonnés concernés, dans Docs, Gmail et Keep.
Google applique également SynthID à tout l’audio généré par ces produits. Le filigrane est imperceptible à l’écoute mais doit permettre de détecter ultérieurement qu’un contenu sonore provient d’un système d’IA Google.
La voix était longtemps une façade posée devant un modèle texte. Avec cette génération, le travail intéressant commence plutôt derrière la façade : parler, regarder, appeler des outils et raisonner sans obliger l’utilisateur à attendre en silence.