
 Par Tsuky
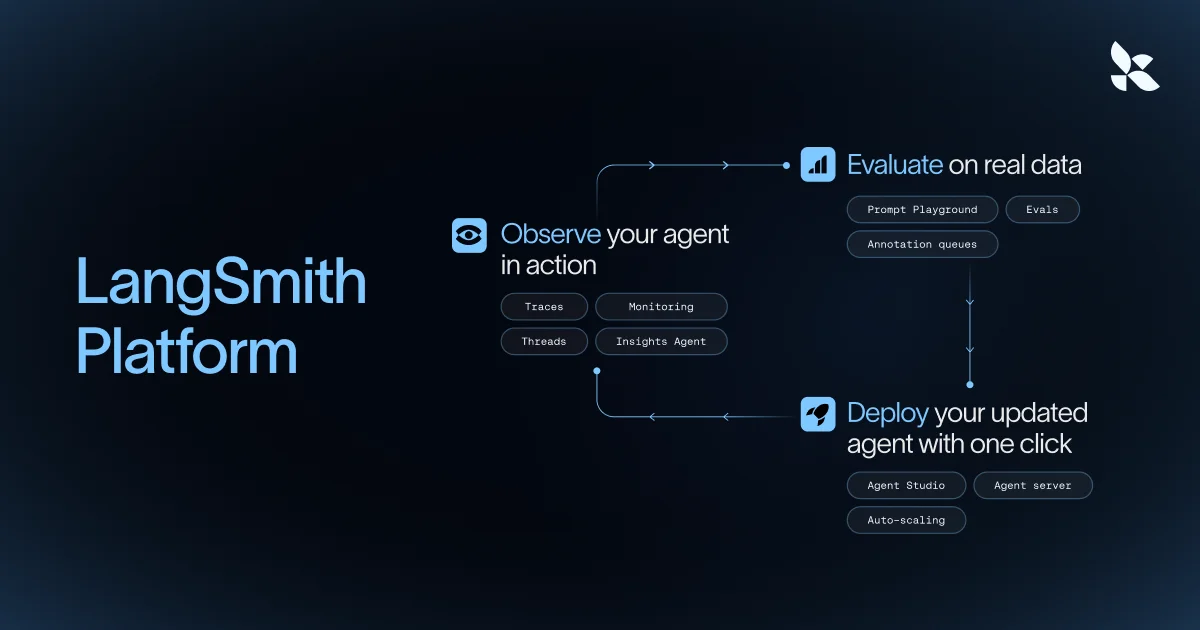
Les traces d'un agent étaient jusqu'ici surtout utiles pour comprendre pourquoi il avait pris une mauvaise décision, appelé le mauvais outil ou gaspillé quelques milliers de tokens en chemin. LangChain veut désormais leur donner une seconde vie. Avec LangSmith Fine-Tuning, disponible en bêta publique, ces traces peuvent alimenter directement un workflow de supervised fine-tuning.
Le nouvel outil s'appelle smithtune. Il s'agit d'un CLI publié par LangChain qui s'appuie sur les « trajectories » de LangSmith : une représentation ordonnée des messages, appels d'outils et résultats rencontrés pendant l'exécution d'un agent. L'intérêt n'est pas seulement de conserver la réponse finale. Pour entraîner un modèle à reproduire un comportement, il faut aussi savoir quel contexte et quels outils étaient visibles au moment où chaque décision a été prise.
Des traces de production jusqu'au dataset
smithtune commence par récupérer des trajectoires depuis un projet de tracing LangSmith. Le workflow prévoit ensuite une étape de sélection des exemples considérés comme bons, avec création d'une grille d'évaluation puis revue des trajectoires candidates. Les exemples retenus sont stockés dans un dataset persistant afin de garder une trace de ce qui a réellement servi à l'entraînement.
Le CLI filtre également les trajectoires incompatibles avec la longueur de séquence du modèle choisi et prépare les séparations nécessaires entre entraînement, validation et évaluation. C'est une partie peu spectaculaire du fine-tuning, mais c'est précisément celle qui transforme rapidement un dossier rempli de logs en pipeline maison difficile à maintenir.
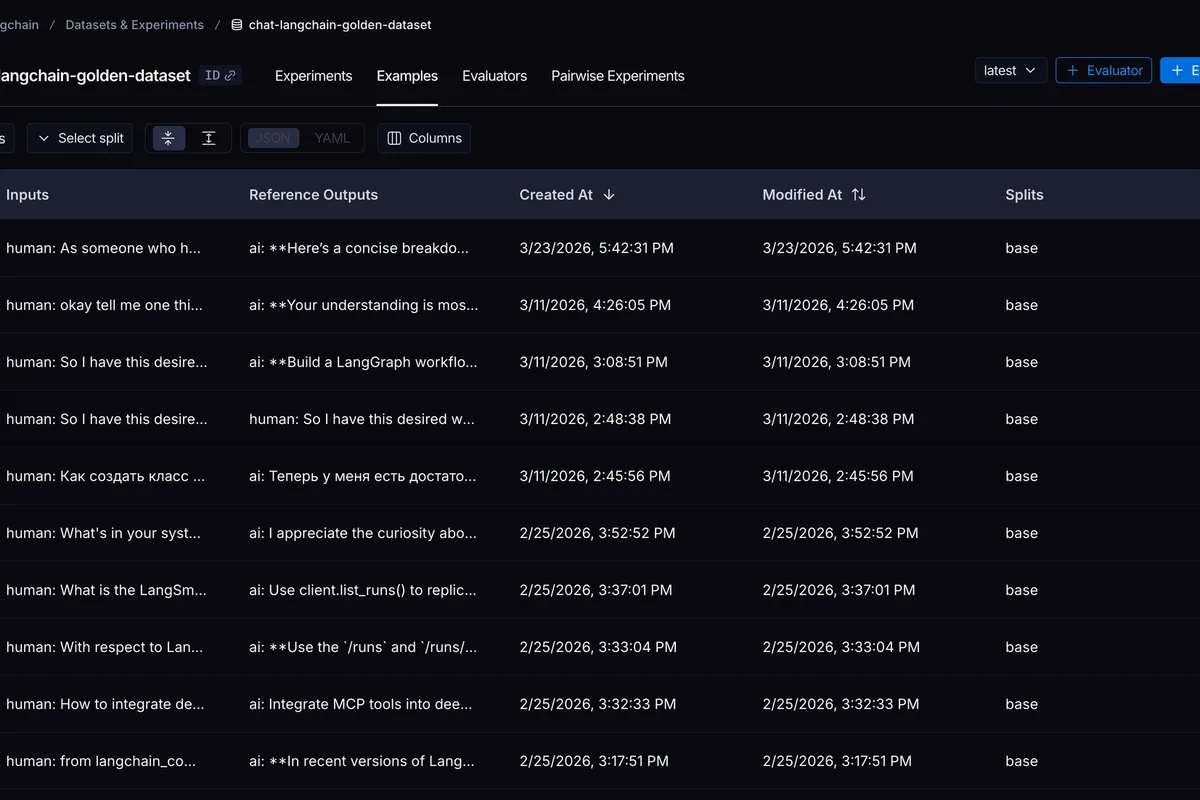
LangChain insiste d'ailleurs beaucoup plus sur la sélection des données que sur le simple fait de lancer un entraînement. La société recommande d'abord d'améliorer le harness de l'agent lorsque c'est possible. Le SFT intervient plutôt quand des erreurs répétitives subsistent et que l'équipe possède déjà de bonnes trajectoires montrant le comportement attendu.
Fireworks ou Baseten derrière la commande train
Une commande smithtune plan permet de vérifier le modèle, le nombre d'exemples et des paramètres comme le learning rate, la taille des batchs ou le nombre d'époques avant de dépenser du calcul. smithtune train transmet ensuite le travail à Fireworks Managed SFT ou à Baseten Loops. Les deux intégrations prennent en charge un entraînement de type LoRA sur les trajectoires préparées.
Le développeur n'a donc pas à provisionner lui-même les GPU pour ce chemin-là. Dans le cas de Baseten, l'entraînement se déroule dans le workspace du client avec sa propre clé API et les checkpoints restent sur la plateforme pour pouvoir être servis ensuite. Baseten précise cependant que Loops est encore en early access, indépendamment du statut de bêta publique annoncé pour LangSmith Fine-Tuning.
L'évaluation fait partie du pipeline, pas du service après-vente
Après l'entraînement, smithtune evaluate rejoue des trajectoires conservées hors du dataset d'entraînement pour comparer le checkpoint au modèle de base. Les actions produites sont confrontées aux exemples enregistrés et les résultats remontent dans LangSmith, où les équipes peuvent examiner les scores, réponses et choix d'outils.
C'est probablement la partie la plus importante du produit. Un modèle spécialisé moins cher n'a pas beaucoup d'intérêt s'il économise trois appels avant d'introduire un nouveau type de régression impossible à voir. Ici, le workflow force au moins la comparaison avant la commande smithtune deploy.
LangChain publie quelques résultats internes pour illustrer le principe. Sur un sous-ensemble de son benchmark IssueBench utilisé avec LangSmith Engine, l'entreprise indique qu'un Kimi K3 fine-tuné atteint un score de 96, contre 90 pour le modèle de base et 87 pour GPT-5.6 Sol. Sur une autre évaluation interne consacrée à OpenSWE Review, le SFT d'un Qwen-3.8-27B ferait passer le F1 de 48,9 % à 53,7 %, avec 29,8 % d'appels modèle et 29,4 % de requêtes outils en moins.
Ces chiffres viennent de LangChain et de ses propres jeux d'évaluation : ce ne sont pas des benchmarks indépendants. Le détail le plus instructif se trouve peut-être ailleurs dans son retour d'expérience. Une première version du dataset, moins sélective, avait au contraire fait baisser le F1 après fine-tuning. L'équipe a dû revenir sur la sélection de ses traces avant d'obtenir une amélioration.
Le fine-tuning revient dans la boucle de développement des agents
LangSmith avait déjà les logs, les datasets et les évaluations. En ajoutant l'entraînement, LangChain essaie maintenant de fermer la boucle : observer le comportement réel d'un agent, isoler de bons exemples, spécialiser un modèle puis mesurer si ce nouveau modèle fait réellement mieux avant de le déployer.
Pour démarrer, LangChain demande un compte LangSmith contenant des traces d'agent, le CLI smithtune et une clé API Fireworks ou Baseten. Le produit est disponible en bêta publique depuis le 24 septembre.