
 Par Adri
Anthropic veut mesurer ce qui se passe derrière les portes des laboratoires
Les performances publiques d'un modèle ne racontent qu'une partie de l'histoire. Elles permettent de voir ce qu'un système sait faire une fois entraîné, mais beaucoup moins rapidement la manière dont les laboratoires utilisent désormais leurs propres modèles pour accélérer la génération suivante.
Anthropic veut donc publier des indicateurs portant directement sur le processus de développement. L'entreprise en propose trois : quelle part de la R&D est effectuée par l'IA, dans quelle mesure les actions des agents peuvent être surveillées et interrompues, et comment la puissance de calcul utilisée pour développer les modèles est répartie.
L'objectif déclaré est de rendre observable depuis l'extérieur une accélération qui, jusqu'ici, se déroule essentiellement à l'intérieur de quelques entreprises privées.
Claude "mène" désormais 26 % de la R&D d'Anthropic
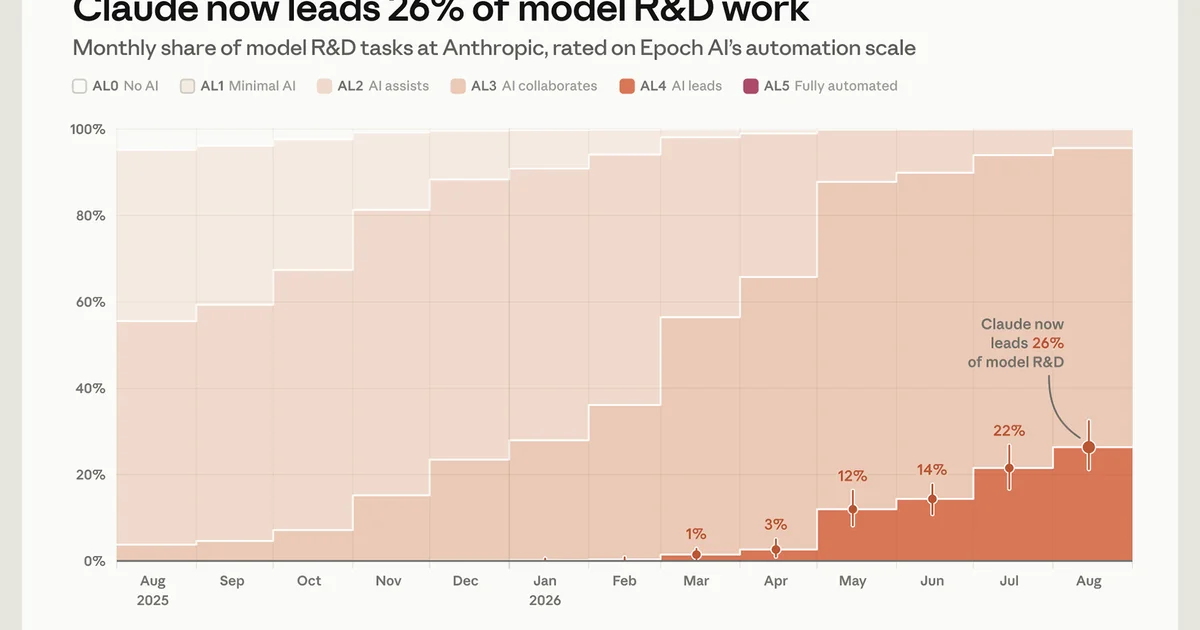
Le chiffre le plus spectaculaire concerne l'automatisation de la recherche elle-même. Anthropic utilise une échelle développée par Epoch AI allant de AL0 à AL5.
AL0 correspond à une tâche sans intervention de l'IA. À AL3, l'IA collabore avec un humain et peut prendre en charge de grandes parties d'un travail sous direction rapprochée. À AL4, l'IA "mène" la tâche : elle peut en accomplir l'essentiel de bout en bout à partir d'une instruction relativement générale, tandis qu'un humain conserve un rôle de supervision.
En août 2026, Anthropic estime que Claude avait atteint ce niveau AL4 pour 26 % de son travail de recherche et développement sur les modèles.
La progression est rapide. Le graphique publié par l'entreprise place cette proportion à environ 1 % en mars, 3 % en avril, 12 % en mai, 14 % en juin, 22 % en juillet puis 26 % en août.
Plus de 90 % de la recherche implique déjà Claude
La proportion devient encore plus importante lorsqu'Anthropic inclut les tâches où Claude ne dirige pas le travail mais collabore avec les chercheurs.
Plus de 90 % de la R&D mesurée se situe désormais au niveau "AI collaborates" ou supérieur. Cela ne signifie pas que 90 % des chercheurs ont été remplacés, ni que Claude réalise seul 90 % du développement.
La distinction est essentielle : une grande partie de ces tâches reste dirigée, contrôlée ou validée par des humains. Anthropic précise d'ailleurs qu'aucune catégorie de travail mesurée n'a encore atteint AL5, le niveau correspondant à une IA travaillant de manière totalement autonome sans humain dans la boucle.
Le phénomène intéressant n'est donc pas une autonomie complète déjà atteinte, mais la vitesse à laquelle l'IA s'intègre dans pratiquement toutes les étapes de sa propre chaîne de développement.
Comment Anthropic arrive-t-il à mesurer quelque chose d'aussi difficile ?
Pour construire son indice, Anthropic a commencé par cartographier le travail réellement effectué dans ses équipes de développement de modèles.
L'entreprise a échantillonné chaque semaine de juillet 20 % des employés de plusieurs départements participant à la boucle de R&D. Des agents Claude ont ensuite analysé leurs documents de travail et communications internes afin d'identifier environ 15 000 tâches individuelles.
Ces tâches ont été regroupées dans une arborescence de 542 catégories, comprenant 378 catégories terminales allant du diagnostic de problèmes sur les plateformes d'évaluation à la gestion de politiques réseau pour les environnements de reinforcement learning.
Anthropic pondère ensuite ces catégories selon le temps humain qui leur est consacré et estime leur niveau d'automatisation.
Il existe pourtant un problème : Claude participe aussi à l'évaluation de Claude
Anthropic reconnaît elle-même une limite méthodologique importante. Une partie de l'analyse et de la classification permettant de déterminer le niveau d'automatisation est réalisée par Claude.
Le système se retrouve donc en partie dans la position inhabituelle d'un modèle évaluant le rôle que ce même modèle joue dans le développement de l'entreprise.
Anthropic a comparé ces évaluations à celles de ses employés. Selon l'entreprise, le modèle et les humains attribuaient exactement le même niveau dans 59 % des cas, et leurs évaluations étaient séparées d'un niveau au maximum dans 97 % des cas.
Cela ne transforme pas la métrique en vérité absolue. La frontière entre une IA qui "collabore" et une IA qui "mène" une tâche reste notamment sujette à interprétation.
30 000 agents peuvent travailler simultanément à l'intérieur d'Anthropic
La deuxième série de mesures donne une idée de l'échelle déjà atteinte par les agents internes.
Anthropic indique qu'environ 30 000 agents effectuaient simultanément des travaux de recherche et d'ingénierie en août sur sa principale plateforme interne.
Ces agents peuvent travailler pendant de longues périodes et déléguer certaines tâches à d'autres agents. Cela pose une question différente de celle des performances : comment surveiller plusieurs dizaines de milliers de systèmes semi-autonomes lorsque leurs actions deviennent de plus en plus nombreuses ?
Anthropic utilise deux niveaux de contrôle. Les moniteurs en ligne examinent les actions avant leur exécution et peuvent les bloquer ou les rediriger. Les moniteurs hors ligne analysent ensuite les traces d'activité afin de rechercher des comportements qui seraient moins immédiatement dangereux mais potentiellement problématiques sur la durée.
Une décision sur 47 000 a été bloquée
Selon Anthropic, 100 % des actions réalisées sur cette plateforme passent par son système de surveillance en ligne avant leur exécution et sont également enregistrées pour l'analyse hors ligne.
Sur plus d'un milliard de décisions prises par les agents de recherche et d'ingénierie durant le mois d'août, environ 0,002 % ont été bloquées par le moniteur en ligne, soit approximativement une décision sur 47 000.
Ce chiffre demande une lecture prudente. Il ne signifie pas qu'une décision sur 47 000 aurait nécessairement produit un incident grave. Le système peut intervenir pour des comportements suspects, des erreurs ou des actions simplement incompatibles avec les règles définies.
À l'inverse, un faible taux de blocage ne prouve pas non plus que toutes les autres décisions sont sans risque. La qualité du résultat dépend directement de la capacité des systèmes de surveillance à identifier les comportements problématiques.
Environ 100 000 conversations sont signalées chaque semaine
Le système de surveillance hors ligne fonctionne à une autre échelle. Anthropic indique qu'environ 100 000 transcriptions d'activité sont signalées chaque semaine avant d'être filtrées par plusieurs classificateurs.
La majorité est éliminée comme faux positif ou résolue automatiquement, tandis qu'environ 50 cas considérés comme prioritaires sont transmis chaque semaine à des humains.
Anthropic souhaite que ce type de statistiques devienne lui aussi comparable entre laboratoires : proportion d'activité réellement surveillée, temps nécessaire avant examen et fréquence à laquelle les systèmes interviennent.
Anthropic publie également combien de calcul il consacre à la sécurité
La troisième métrique concerne une ressource beaucoup plus tangible : la puissance de calcul.
Anthropic a étudié l'ensemble de son utilisation de calcul entre le 13 et le 20 juillet 2026. Sur cette période, environ 6 % du calcul destiné à la R&D sur l'intelligence artificielle était consacré à des travaux classés comme relevant de la sécurité.
Pour la partie de la R&D réalisée directement avec l'aide de l'IA, cette proportion atteignait environ 12 %.
L'entreprise présente ces estimations comme conservatrices : lorsqu'une charge de calcul pouvait améliorer à la fois les capacités et la sécurité d'un modèle, elle n'était pas comptabilisée comme recherche de sécurité.
Le pourcentage de calcul n'est toutefois pas une mesure parfaite de l'effort de sécurité
Une comparaison brute possède ses limites. Certaines recherches de sécurité reposent principalement sur le travail humain, l'analyse ou la conception d'expériences et consomment beaucoup moins de GPU qu'un entraînement massif.
Une entreprise pourrait donc consacrer beaucoup de chercheurs à la sécurité sans que cela représente une énorme proportion de son calcul total.
Anthropic reconnaît cette limite. L'intérêt de la métrique réside surtout dans sa capacité à suivre une même entreprise dans le temps ou, si des définitions communes apparaissent, à effectuer des comparaisons entre laboratoires.
L'enjeu derrière ces chiffres est la boucle d'amélioration de l'IA
Ce que cherche réellement à mesurer Anthropic dépasse finalement Claude lui-même. Lorsqu'une IA aide à coder les outils, exécuter les expériences, analyser les résultats et modifier l'infrastructure servant à entraîner son successeur, chaque nouvelle génération peut théoriquement accélérer la suivante.
Cette idée est souvent décrite sous le terme d'amélioration récursive. La version extrême serait un système suffisamment autonome pour concevoir son propre successeur sans intervention humaine significative.
Les chiffres publiés par Anthropic montrent précisément que ce stade n'est pas encore atteint dans les tâches qu'elle mesure : aucune n'est classée AL5.
Mais ils montrent aussi pourquoi le sujet est désormais concret. Passer d'environ 1 % de tâches menées par Claude en mars à 26 % cinq mois plus tard transforme une hypothèse de recherche en tendance qu'il devient possible de suivre.
Anthropic veut faire vérifier ses propres chiffres par des tiers
L'une des faiblesses évidentes d'un tel système est que les données restent produites par le laboratoire qu'elles sont censées rendre plus transparent.
Anthropic annonce donc vouloir accueillir des évaluateurs indépendants provenant de plusieurs organisations. Ceux-ci devraient recevoir un accès aux processus, systèmes et données internes comparable à celui des équipes chargées de l'évaluation des risques dans l'entreprise.
Ils pourraient notamment vérifier les pratiques de sécurité, examiner des incidents et contrôler les métriques publiées.
Si ce modèle fonctionne, le changement important ne serait peut-être pas seulement qu'Anthropic publie davantage de chiffres. Ce serait que la vitesse de développement des systèmes de pointe devienne enfin quelque chose qu'un observateur extérieur peut mesurer plutôt qu'une information connue uniquement des entreprises qui les construisent.
Le benchmark le plus important pourrait bientôt ne plus mesurer un modèle
Les benchmarks traditionnels continueront d'être indispensables pour mesurer les capacités d'une IA. Mais ils regardent essentiellement le résultat final.
L'indice proposé par Anthropic regarde plutôt le moteur de la progression : quelle quantité de travail l'IA peut effectuer pour accélérer sa prochaine version.
Si l'entreprise continue de publier ces données, l'évolution du taux de 26 % pourrait devenir particulièrement révélatrice. Une progression lente indiquerait que certaines parties du développement restent difficiles à automatiser. Une progression rapide vers les niveaux AL4 puis AL5 signalerait au contraire qu'une part croissante de la boucle de R&D peut fonctionner avec une intervention humaine réduite.
Et dans ce cas, la question ne serait plus seulement de savoir à quel point le prochain Claude sera meilleur que l'actuel. Il faudrait aussi mesurer à quel point le Claude actuel a lui-même accéléré son arrivée.