
 Par Tsuky
Anthropic a publié le 17 septembre une série de métriques qu’elle souhaite voir devenir plus communes dans les laboratoires d’IA frontier.
L’idée est assez simple : les performances finales des modèles sont déjà abondamment mesurées, mais le processus qui les produit reste beaucoup plus opaque.
Combien du prochain modèle est réellement construit par le modèle actuel ? Combien d’actions effectuées par des agents internes sont surveillées ? Quelle fraction de la puissance de calcul destinée à la R&D part vers des travaux explicitement classés comme sécurité ?
Anthropic propose trois familles d’indicateurs pour commencer à répondre à ces questions.
Le premier chiffre attire forcément l’œil : 26 %
Anthropic a construit un prototype baptisé R&D Automation Index.
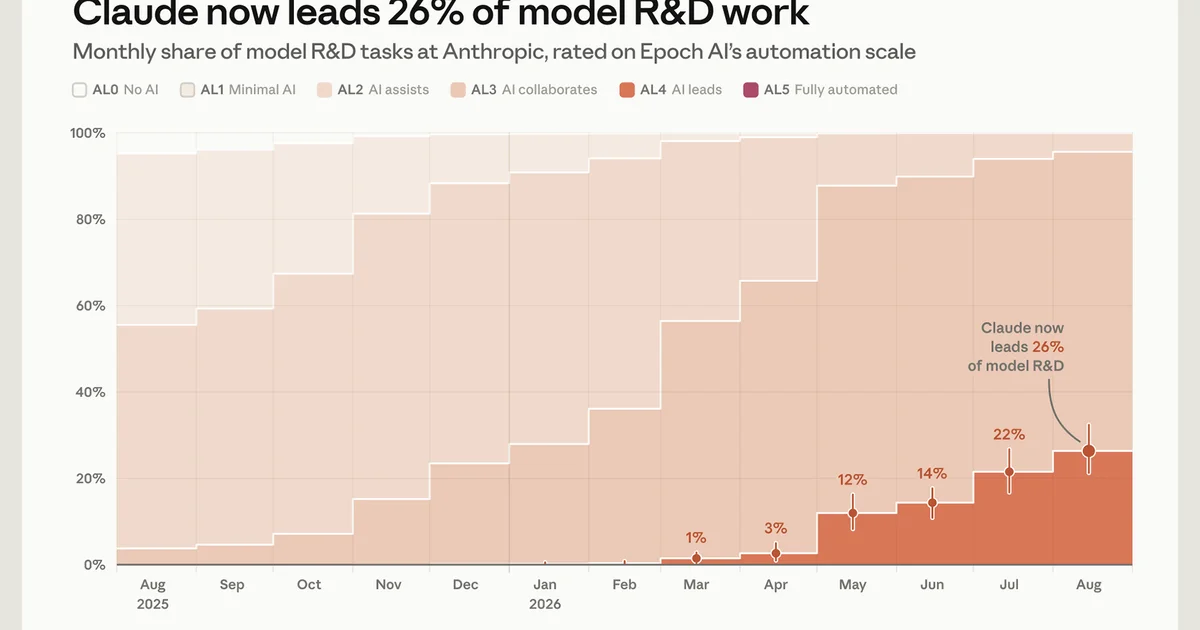
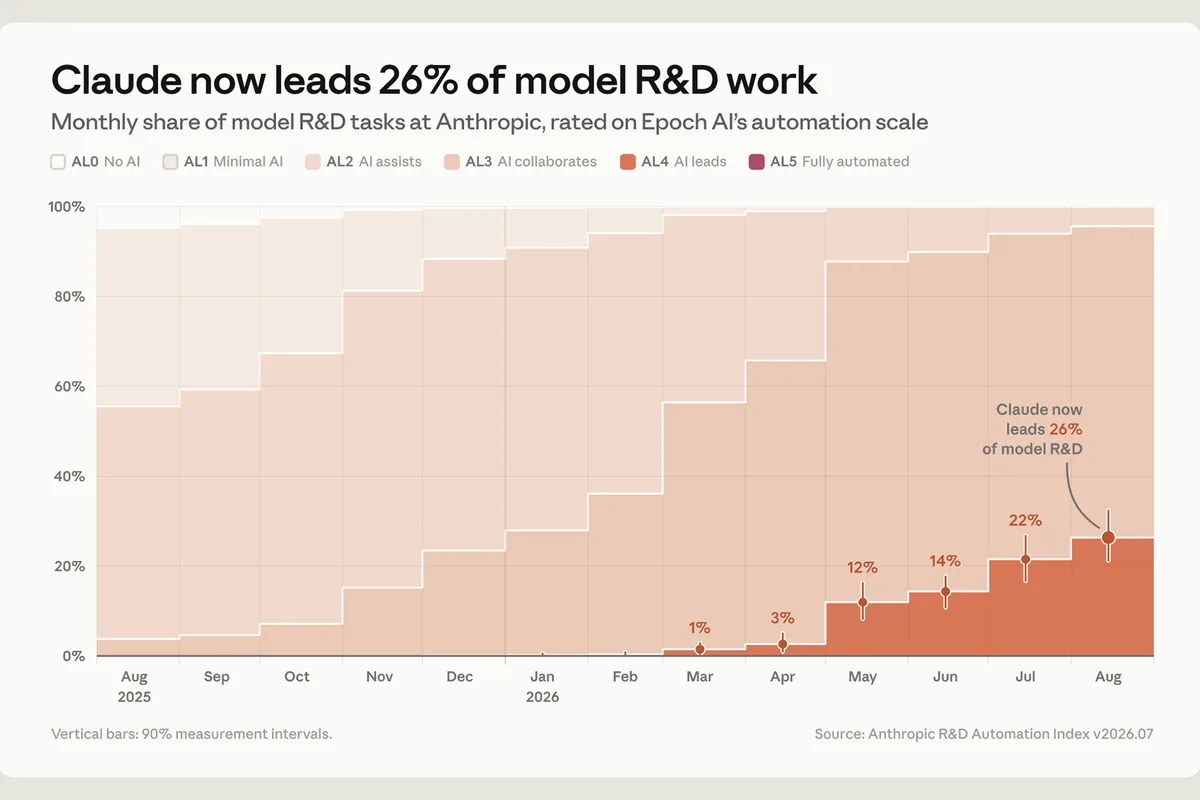
Selon cette mesure, Claude « dirigeait » 26 % de la R&D modèle de l’entreprise en août 2026.
Le mot « dirige » possède ici une définition assez précise.
Anthropic utilise l’échelle d’automatisation développée par Epoch AI, qui va de AL0, sans intervention d’IA, à AL5, où une IA accomplit le travail de manière entièrement autonome sans humain dans la boucle.
Le niveau AL3, « collaborates », correspond à une IA capable d’effectuer de larges portions du travail sous une direction humaine encore étroite.
AL4, « leads », signifie qu’un humain peut donner un objectif relativement haut niveau puis laisser l’IA effectuer la majorité de la tâche de bout en bout, avant supervision ou validation finale.
Les 26 % correspondent à ce quatrième niveau.
Ce n’est pas 26 % d’une entreprise entièrement automatisée
La nuance est importante parce que ce pourcentage peut facilement être interprété trop largement.
Anthropic ne dit pas que Claude produit seul 26 % du prochain modèle, ni que 26 % de ses employés pourraient disparaître.
La mesure porte sur un panier de tâches de R&D modèle, pondérées selon le temps humain qui leur est consacré.
Un niveau AL4 conserve un humain dans la boucle. Celui-ci peut ne plus suivre chaque étape en direct, mais il reste responsable de la supervision et de décisions comme le déploiement final d’un correctif.
Anthropic précise par ailleurs qu’aucun sous-ensemble mesuré de sa R&D n’atteint actuellement AL5, le niveau totalement autonome.
En revanche, l’IA intervient déjà presque partout
Le deuxième nombre est peut-être plus révélateur.
Plus de 90 % du travail mesuré atteint au moins AL3, le niveau où l’IA « collabore » réellement au travail plutôt que de fournir une aide marginale.
Autrement dit, les tâches de R&D modèle réalisées sans implication importante de Claude sont déjà minoritaires dans le panier construit par Anthropic.
L’évolution a également été rapide.
Le graphique publié par l’entreprise montre que la portion classée AL4 était encore inférieure à 1 % en février 2026. Elle atteint 1 % en mars, 3 % en avril, 12 % en mai, 14 % en juin, 22 % en juillet puis 26 % en août.
Il s’agit d’une mesure interne, pas d’un benchmark indépendant de productivité.
Pour produire l’indice, Anthropic a d’abord dû définir ce qu’est réellement sa R&D
C’est probablement la partie la plus intéressante de la méthodologie.
Une entreprise ne possède pas forcément une liste propre et stable intitulée « toutes les tâches nécessaires pour construire un modèle frontier ».
Anthropic est donc partie de traces de travail internes.
Pour chacune des semaines de juillet, l’entreprise a échantillonné 20 % du personnel dans les départements participant à la boucle de R&D modèle.
Un agent Claude a ensuite étudié Slack et diverses documentations internes afin de déterminer les tâches réalisées.
L’opération a produit environ 15 000 tâches granulaires.
Ces 15 000 tâches ont été condensées en un arbre de 542 catégories
Claude a organisé cet inventaire dans une hiérarchie allant de domaines très larges vers des travaux de plus en plus spécifiques.
L’arbre obtenu contient 542 nœuds, dont 378 feuilles.
Anthropic donne des exemples comme le diagnostic et la correction de défauts sur une plateforme d’évaluation, les politiques réseau d’environnements de reinforcement learning ou encore les analyses post-incident de systèmes de serving.
Cet arbre est ensuite figé.
Les mesures mensuelles utilisent ainsi le même panier, ce qui permet d’observer si les mêmes familles de travail deviennent progressivement plus automatisées.
L’indice est pondéré par le temps humain, pas par le nombre de tickets
Compter chaque tâche de manière identique produirait une mesure étrange.
Corriger un petit script et modifier un élément majeur de la chaîne d’entraînement représenteraient chacun une unité.
Anthropic utilise donc le temps humain comme approximation de l’importance relative.
Chaque personne reçoit une unité de poids pour une semaine, répartie entre les tâches auxquelles elle a participé.
Si quelqu’un travaille sur quatre sujets, chacun reçoit 0,25 unité. Sur dix sujets, chacun en reçoit 0,10.
Le poids d’une catégorie correspond ensuite à la somme des fractions de temps qui lui sont attribuées.
Puis Claude juge... combien Claude a automatisé
C’est la faiblesse méthodologique la plus évidente, et Anthropic la reconnaît elle-même.
Pour chaque catégorie, un agent Claude recherche comment le travail est réalisé, qui le fait, quels outils sont employés et quelle part est exécutée par l’IA.
Un autre Claude indépendant examine ensuite les éléments recueillis et attribue le niveau d’automatisation.
Le système utilise donc en partie des modèles de la même famille pour évaluer l’importance de cette famille dans le travail.
Une erreur systématique du juge pourrait se retrouver dans l’indice.
Anthropic a tout de même comparé le juge IA à des humains
Les responsables humains de différentes zones de travail ont évalué leurs propres niveaux d’automatisation sans connaître la conclusion produite par les agents.
Selon Anthropic, le modèle et les humains donnaient exactement la même catégorie dans 59 % des cas.
Deux humains n’étaient eux-mêmes exactement d’accord que dans 35 % des comparaisons.
Surtout, la note du modèle se trouvait à moins d’un niveau de celle des humains dans 97 % des cas.
Cela ne rend pas la mesure objective.
Cela montre surtout qu’une frontière comme celle séparant « AI collaborates » de « AI leads » est déjà suffisamment floue pour que les évaluateurs humains divergent eux aussi.
L’indice possède une autre limite : il mesure un panier de travail gelé
Si les anciennes tâches deviennent automatisées mais que les chercheurs utilisent le temps libéré pour inventer des catégories entièrement nouvelles de travail, l’indice pourrait donner une image trompeuse.
Anthropic a essayé de tester cette possibilité en construisant également un panier à partir de janvier 2026 puis en comparant les nouvelles tâches observées entre février et juillet.
L’entreprise dit ne pas avoir constaté de hausse du nombre de tâches « nouvelles » au niveau de granularité utilisé.
Elle prévoit néanmoins de reconstruire périodiquement le panier et de versionner les résultats.
Le deuxième instrument ne mesure plus le travail, mais la surveillance
L’automatisation n’est qu’une moitié du problème.
Si des milliers d’agents effectuent davantage de travail sans attention humaine continue, il faut aussi mesurer combien de leurs actions sont réellement observées.
Anthropic propose donc trois autres données : la couverture de monitoring, la latence de revue et le taux de blocage ou d’escalade.
En août 2026, environ 30 000 agents effectuaient simultanément du travail de recherche et d’ingénierie sur la plateforme interne la plus utilisée par Anthropic.
Le chiffre concerne cette plateforme uniquement, pas nécessairement tous les agents de l’entreprise.
Les 30 000 agents passent par deux niveaux de surveillance
Le premier fonctionne en ligne, avant l’action.
Selon Anthropic, 100 % des actions de ces agents passent par ce moniteur avant exécution.
Il peut bloquer une action considérée comme dangereuse ou rediriger le comportement.
Ce contrôle vise notamment des événements qui pourraient produire rapidement un dommage difficile à annuler, par exemple une tentative de copie de poids de modèle hors des systèmes autorisés.
Les décisions bloquées doivent ensuite recevoir une revue humaine dans un délai d’une semaine.
Sur plus d’un milliard de décisions, 0,002 % ont été bloquées
Anthropic dit avoir analysé plus d’un milliard de décisions effectuées par ses agents de recherche et d’ingénierie en août.
Le moniteur en ligne en a bloqué environ 0,002 %, soit approximativement une décision sur 47 000.
Ce taux n’indique pas à lui seul combien d’actions dangereuses ont réellement été tentées.
Une action bloquée peut être un vrai problème ou un faux positif, tandis qu’une action incorrecte peut aussi ne pas être détectée.
C’est précisément pourquoi Anthropic considère le taux de blocage comme une métrique à publier avec la couverture et les résultats de tests indépendants, plutôt que comme une preuve suffisante de sécurité.
Un deuxième moniteur relit tout après coup
La surveillance offline ingère également 100 % des activités des agents concernés, mais après leur exécution.
Elle vise davantage les comportements qui se développent lentement et peuvent être examinés rétrospectivement.
Le système signale environ 100 000 transcriptions par semaine.
Celles-ci passent ensuite par plusieurs classifieurs chargés d’éliminer les faux positifs et d’effectuer une première revue.
Environ cinquante alertes prioritaires par semaine atteignent finalement un humain.
Anthropic indique que le moniteur offline signale globalement une à deux transcriptions sur mille pour examen supplémentaire.
L’architecture interne donne aussi une identité persistante à chaque agent
Anthropic décrit deux choix destinés à rendre cette flotte plus auditable.
Chaque agent possède d’abord une identité individuelle.
Les informations qu’il crée restent attachées à cette identité même si le modèle sous-jacent est remplacé lors d’une mise à niveau.
Une action peut donc être reliée à l’historique de l’agent qui l’a effectuée.
Les agents utilisent également un système de communication partagé plutôt que des échanges privés impossibles à suivre.
Les messages conservent l’identité de leur auteur et peuvent être reliés aux transcriptions correspondantes.
L’objectif est de permettre au monitoring de traverser non seulement les actions d’un agent, mais aussi les échanges entre agents.
La troisième métrique est probablement la plus facile à auditer : où part le calcul ?
Anthropic propose enfin de publier la répartition de la puissance de calcul.
Contrairement à une notion comme « degré d’autonomie », le nombre d’accélérateurs et le temps pendant lequel ils travaillent sont des quantités relativement concrètes.
L’entreprise a pris une photographie de l’ensemble de son compute entre le 13 et le 20 juillet 2026.
Chaque workload a été classé dans quelques grandes catégories, puis Anthropic a cherché quelle part du calcul de R&D pouvait être considérée comme explicitement consacrée à la sécurité.
Le résultat est de 6 %, mais le dénominateur compte beaucoup
Durant cette semaine, environ 6 % du calcul consacré à la R&D IA a été classé comme travail de sécurité.
Pour la portion de calcul utilisée spécifiquement par des IA effectuant de la R&D IA, la part classée sécurité atteint environ 12 %.
Ces deux nombres ne doivent pas être additionnés : ils reposent sur des ensembles différents.
Anthropic explique également avoir utilisé une définition volontairement conservatrice.
Lorsqu’un workload faisait progresser à peu près autant les capacités que la sécurité, il était classé comme R&D et non comme sécurité.
Les classifieurs de sécurité ne sont même pas inclus dans les 6 %
Anthropic indique que ces chiffres excluent le calcul utilisé par ses classifieurs de safeguards.
Selon l’entreprise, cette consommation représente séparément un volume de calcul comparable.
Cela ne signifie pas qu’il faudrait simplement doubler le pourcentage.
Les catégories ne correspondent pas au même usage et Anthropic les sépare volontairement.
La société insiste également sur une limite structurelle : la recherche de sécurité peut demander énormément de temps humain sans utiliser beaucoup de GPU.
Comparer uniquement des FLOPs ne mesure donc pas l’ensemble de l’effort consacré à la sécurité.
La classification du « travail de sécurité » est elle-même contestable
Certaines expériences possèdent naturellement deux effets.
Une technique de supervision plus robuste peut rendre un modèle plus sûr tout en le rendant également plus capable ou plus utile commercialement.
Anthropic a construit une définition écrite accompagnée de cas limites puis utilisé un classifieur Claude pour répartir les workloads.
Sur les runs d’entraînement et d’évaluation, le système lit notamment les métadonnées et le code associé.
Sur les sessions d’agents de recherche, une variante examine les transcriptions lorsqu’elles sont accessibles.
Le laboratoire reconnaît que plusieurs cas sont restés difficiles à classer même après plusieurs heures de revue humaine.
La mesure repose aussi sur un échantillon, pas sur chaque run
Pour les runs de recherche, entraînement et évaluation, Anthropic indique qu’un peu moins de 10 000 jobs existaient sur la période étudiée.
Environ 14 % ont été échantillonnés pour classification.
L’échantillonnage donne davantage de poids aux runs consommant le plus de calcul afin que le résultat représente mieux la répartition réelle des accélérateurs que le simple nombre de jobs.
Anthropic prévoit de rendre ce pipeline suffisamment reproductible pour qu’un tiers puisse reclasser aléatoirement des jobs et comparer les résultats.
Pourquoi publier tout cela maintenant ?
Anthropic présente ces métriques comme des instruments possibles pour réduire l’écart d’information entre laboratoires, évaluateurs externes, gouvernements et public.
L’entreprise avance aussi qu’elles pourraient, à terme, servir de base à des engagements ou à des règles : délai fixe de test avant qu’un modèle soit utilisé dans davantage de R&D, obligations de publication, ou objectifs concernant la part de calcul destinée à la sécurité.
Ce sont des propositions d’Anthropic, pas des standards adoptés par l’industrie ni des obligations réglementaires existantes.
Le laboratoire affirme vouloir intégrer des évaluateurs indépendants issus de plusieurs organisations et leur donner un accès à des processus, systèmes et données comparable à celui de ses équipes internes d’évaluation des risques.
Comparer Anthropic à OpenAI, Google ou xAI avec ces chiffres serait prématuré
Aucun référentiel commun n’existe encore.
Un autre laboratoire pourrait définir « AI leads » différemment, construire un panier de tâches différent ou tracer ailleurs la frontière entre sécurité et capacités.
Deux entreprises publiant chacune « 25 % de R&D automatisée » pourraient donc parler de réalités assez éloignées.
Anthropic cite précisément l’absence de méthodologie commune comme l’un des principaux obstacles à une comparaison inter-laboratoires.
La proposition ne devient réellement utile comme instrument industriel que si les définitions convergent et si les audits externes peuvent vérifier que les nombres sont produits de manière comparable.
Le chiffre de 26 % n’est donc peut-être pas la donnée la plus importante
Il donne une image frappante de l’accélération actuelle : en quelques mois, Claude serait passé de presque aucune tâche classée AL4 à plus d’un quart du panier de R&D modèle.
Mais l’élément plus durable pourrait être la tentative de transformer cette boucle d’auto-accélération en quelque chose de mesurable.
Tant que la progression interne d’un laboratoire n’apparaît qu’au moment où un nouveau modèle est publié, l’extérieur ne voit qu’une succession de résultats.
Un index d’automatisation, la couverture du monitoring et les allocations de compute permettraient au moins de regarder une partie de la machine qui produit ces résultats.
Pour l’instant, cette fenêtre a encore été construite, remplie et mesurée presque entièrement par Anthropic elle-même.
C’est précisément la prochaine étape que ses propres chiffres rendent difficile à éviter : si ces métriques doivent devenir autre chose qu’un intéressant audit interne, ce sont désormais leur répétabilité et leur vérification indépendante qui devront être mesurées.