
 Par Tsuky
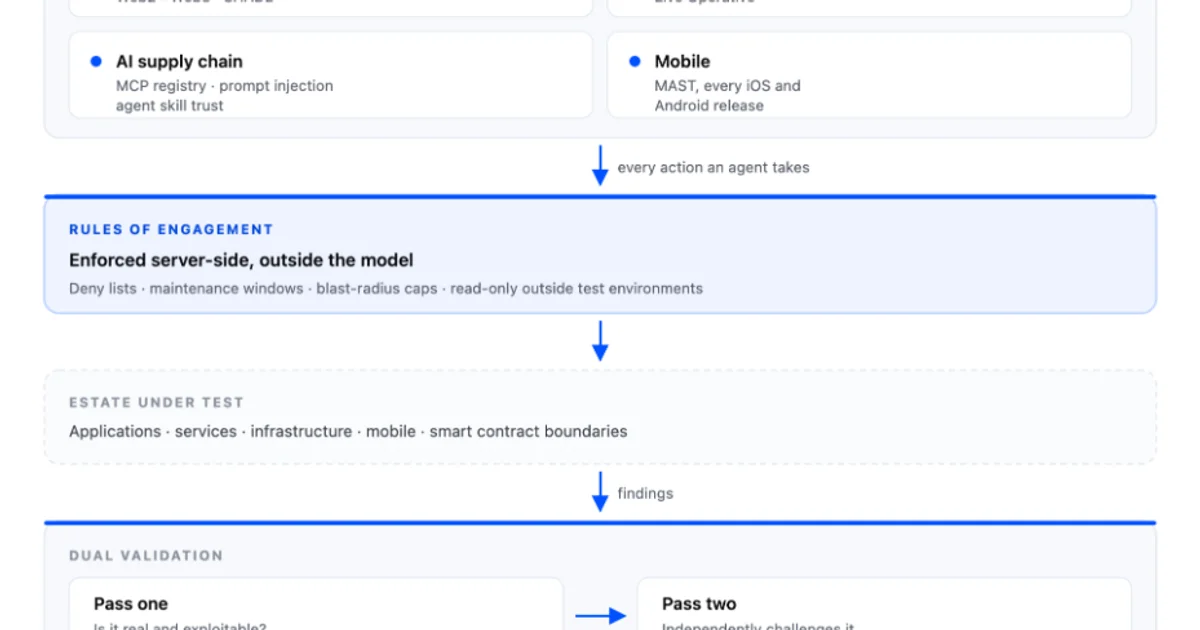
Coinbase a dévoilé le 15 septembre CAT, pour Continuous Adversarial Testing, une plateforme interne conçue pour lancer en permanence des agents IA spécialisés contre ses propres systèmes.
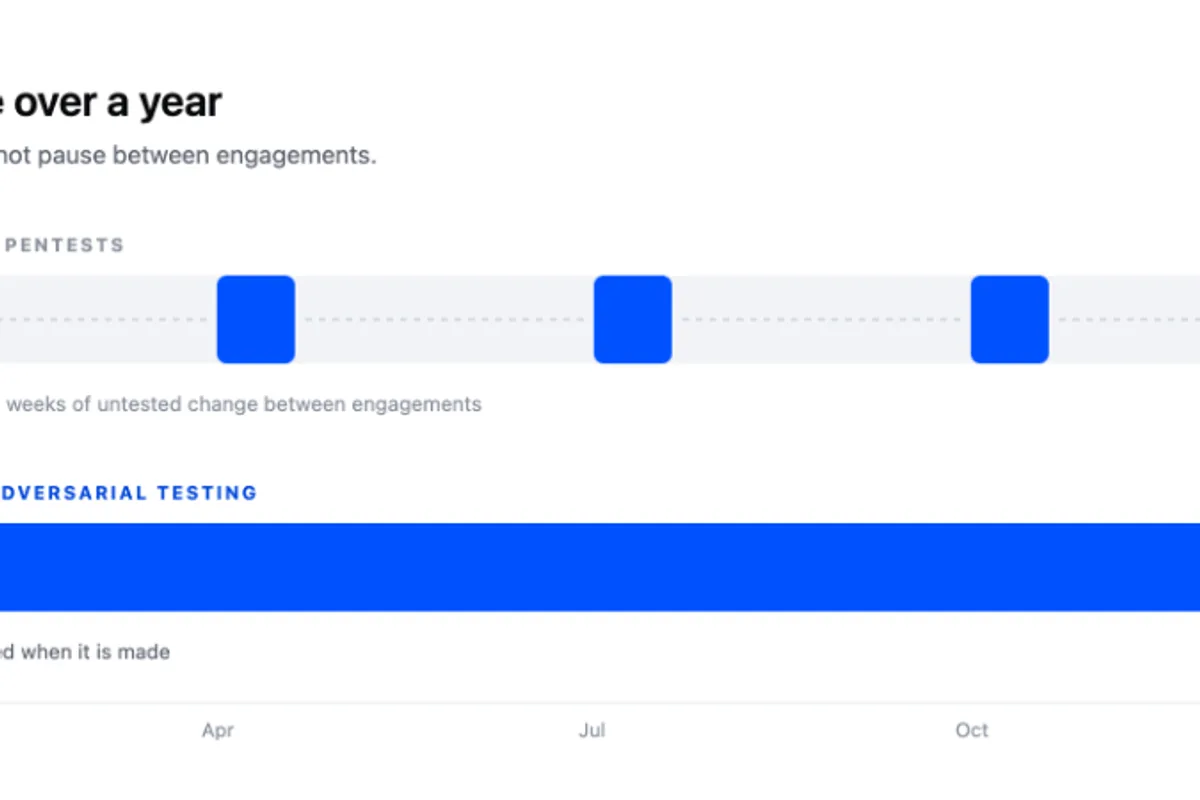
L’objectif est assez différent d’un pentest annuel ou d’un scanner SAST exécuté avant une release.
CAT surveille les nouveaux commits, les mises en production, les nouveaux services et les changements de surface d’attaque au fur et à mesure qu’ils apparaissent. Les actifs déjà existants peuvent également être réévalués lorsque le contexte le justifie.
Coinbase indique que le système couvre les applications web et mobiles, les services backend, l’infrastructure, les interfaces entre systèmes Web2 et smart contracts ainsi que ses outils IA internes.
Chaque pull request peut désormais devenir une cible de pentest
La première couche de CAT intervient avant même que le code arrive en production.
Coinbase explique que les agents analysent les commits lorsqu’ils arrivent, effectuent une nouvelle revue au moment du merge et intègrent ensuite ces résultats dans un contrôle plus large lors du lancement du produit.
Les trois niveaux utilisent des modèles IA dits de frontière, avec des budgets et profondeurs d’analyse différents selon le type de changement.
L’idée consiste à déplacer une partie de la découverte de vulnérabilités le plus tôt possible dans le cycle de développement.
Un défaut détecté dans la pull request peut être corrigé par le développeur avant que le code ne devienne une vulnérabilité réellement exposée.
Le système ne se limite pas à chercher des motifs dans le code
CAT inclut des analyses SAST classiques, mais Coinbase lui donne également accès à suffisamment de contexte pour raisonner sur les flux de données et les chemins d’attaque à travers plusieurs composants.
Un agent peut par exemple partir d’un repository, suivre un backend jusqu’à un smart contract et analyser les points où les deux mondes se rencontrent.
Le système peut également faire le chemin inverse : partir d’une adresse de contrat et rechercher les services qui l’appellent.
Ce type d’analyse est particulièrement pertinent pour une entreprise crypto.
Une vulnérabilité critique ne se trouve pas forcément dans Solidity ou dans le backend pris séparément. Elle peut exister dans l’hypothèse que chacun fait sur l’autre.
SHADE transforme le pentest en problème parallélisable
Coinbase utilise également un composant appelé SHADE, pour Swarm Harness for Adversarial Discovery and Exploitation.
Son principe est de répartir le travail entre plusieurs agents spécialisés. Chacun prend en charge un dépôt ou un périmètre et recherche des vulnérabilités exploitables avant de transmettre ses résultats à la plateforme centrale.
La sécurité offensive devient ainsi horizontalement scalable de la même manière qu’un traitement informatique classique.
Ajouter davantage d’agents permet de couvrir davantage de repositories ou de services en parallèle, sous réserve du coût des modèles et des limites imposées aux tests.
Coinbase ne publie pas suffisamment de résultats indépendants pour mesurer la précision absolue du système face à des pentesters humains. Le chiffre important est donc pour l’instant la couverture obtenue, pas une prétendue supériorité générale de l’IA.
CAT surveille également les MCP et les agents de Coinbase
La plateforme attaque aussi la propre chaîne d’approvisionnement IA de Coinbase.
Un scanner dédié contrôle les serveurs MCP adoptés par les équipes et recherche également des serveurs non enregistrés que Coinbase qualifie de shadow MCP.
Les changements sont rescannés lorsqu’ils apparaissent.
Les agents inspectent également les modifications de code susceptibles d’introduire un chemin de prompt injection : instructions système, définitions d’outils ou données non fiables transmises à un modèle.
Enfin, les capacités accordées aux agents internes sont elles-mêmes analysées avant leur adoption et lorsqu’elles évoluent.
C’est une conséquence logique de l’agentification des systèmes : un nouvel outil accordé à un modèle devient lui-même une modification de la surface d’attaque.
L’application mobile est attaquée à chaque release
CAT intègre aussi MAST, une couche dédiée aux versions iOS et Android.
Coinbase indique vérifier notamment l’OWASP Mobile Top 10, la conformité MASVS, les permissions, les flux de données tiers et la résistance aux réseaux hostiles de type man-in-the-middle.
La société précise qu’une partie des contrôles MASVS continue à faire l’objet d’une vérification manuelle.
Cette coexistence est importante parce que toutes les propriétés de sécurité ne sont pas correctement observables par un agent uniquement à partir de code et de télémétrie.
CAT peut aussi ouvrir l’application comme un véritable attaquant
La partie dynamique comprend un agent DAST capable de s’authentifier comme un utilisateur réel, parcourir une application et enchaîner plusieurs observations.
Coinbase dit viser notamment les injections, les défauts de contrôle d’accès et les bugs de logique métier que les scanners conventionnels détectent difficilement.
Cette dernière catégorie est précisément l’une des raisons pour lesquelles les LLM intéressent les équipes offensives.
Une règle métier problématique ne ressemble pas toujours à une ligne de code manifestement dangereuse.
Il faut parfois comprendre qu’un utilisateur peut combiner plusieurs fonctions légitimes dans un ordre inattendu pour produire un résultat que le produit n’avait jamais prévu.
Mais en production, l’agent n’a pas le droit de tout essayer
C’est probablement la partie la plus importante de CAT.
Coinbase affirme que les règles d’engagement ne sont pas confiées au prompt du modèle.
Elles sont imposées côté serveur, en dehors de l’agent, puis vérifiées une seconde fois par le scanner avant qu’une action réseau soit réellement exécutée.
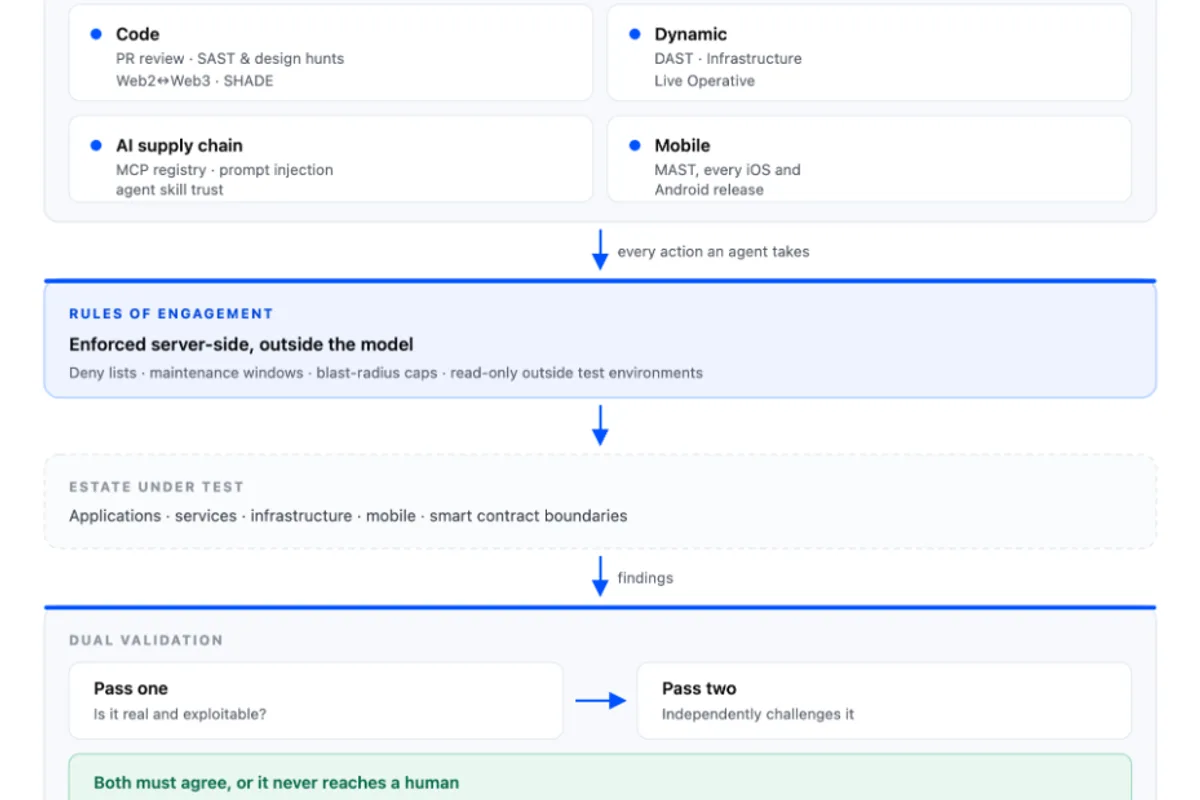
Une deny list reste prioritaire sur tout autre périmètre autorisé.
Des fenêtres temporelles limitent quand les tests peuvent avoir lieu, tandis que des caps de blast radius limitent le nombre de systèmes susceptibles d’être touchés.
Les services fragiles peuvent être totalement exclus du probing actif.
Un kill switch global permet également d’arrêter l’ensemble de la flotte.
Le prompt n’est donc pas la vraie frontière de sécurité
Coinbase formule explicitement le principe : la politique que le modèle voit n’est pas la politique effectivement appliquée.
Un deuxième garde-fou examine ce que chaque commande proposée va réellement faire avant son exécution.
Les actions en lecture seule sont autorisées dans les limites du périmètre.
Toute opération susceptible de modifier des données ou un état est bloquée sauf si la cible a été explicitement déclarée comme environnement non productif lors du cadrage.
Cette vérification se fait dans la couche d’exécution de l’outil, et non dans le system prompt.
Un agent confus, compromis par prompt injection ou simplement trop enthousiaste ne peut donc pas négocier avec cette règle en produisant un meilleur texte.
C’est probablement l’architecture la plus transférable à d’autres usages agentiques : l’IA propose, mais l’autorité réelle reste détenue par un système déterministe extérieur.
Trouver cent fois plus d’alertes ne servirait à rien si elles étaient toutes fausses
L’autre problème du pentest automatisé est le bruit.
Coinbase a donc construit une chaîne de validation avant qu’un résultat n’arrive chez un humain.
Un contrôle initial vérifie d’abord que les outils nécessaires au test fonctionnent réellement : recherche dans le code, modèle, ticketing, infrastructure et télémétrie.
Cela évite par exemple qu’une indisponibilité du moteur de recherche soit interprétée par l’agent comme l’absence d’une protection ou d’un appel.
Un premier agent compare ensuite le finding au code source et au contexte réel du système.
S’il paraît crédible, une trace indépendante vérifie le chemin exact depuis le point d’entrée jusqu’au code vulnérable et examine les contrôles rencontrés au passage.
Un deuxième agent est payé pour contredire le premier
Le résultat est ensuite soumis à une deuxième passe IA indépendante.
Ce second modèle voit le raisonnement précédent et les preuves, mais son rôle consiste explicitement à rechercher les erreurs de la première conclusion.
S’il considère qu’un verdict négatif n’a pas été suffisamment approfondi, CAT peut déclencher une troisième passe plus poussée.
Coinbase limite cette escalade à trois passages afin d’éviter une boucle de réflexion sans fin.
Seuls les résultats confirmés continuent vers le système de suivi.
L’exploitabilité est comparée au vrai trafic de production
Après validation technique, Coinbase applique encore plusieurs vérifications contextuelles.
Le système tente d’évaluer la probabilité réelle d’exploitation avec les caractéristiques du trafic de production.
Des revues séparées examinent ensuite la sensibilité des données et l’impact opérationnel à partir des classifications, objectifs de disponibilité et historiques d’incidents.
Pour les vulnérabilités exposées sur Internet, CAT consulte également les logs de production et la télémétrie du WAF afin de rechercher des signes indiquant qu’un attaquant tente déjà d’exploiter le défaut.
La sortie finale doit donc contenir davantage qu’une simple phrase du type « ce code paraît vulnérable ».
Elle doit fournir un chemin reproductible, un impact contextualisé et une trace exploitable par un humain.
Coinbase a même remplacé CVSS par son propre modèle de gravité
L’entreprise estime que CVSS ne représente pas suffisamment bien ses risques particuliers.
CAT emploie donc une grille à six facteurs.
Trois concernent notamment la probabilité : fréquence d’exploitation, complexité de l’attaque et niveau d’accès nécessaire.
Trois autres évaluent directement les impacts sur les fonds, les données et les opérations.
L’idée est qu’une faille susceptible d’exposer des actifs clients ne soit pas réduite à une note générique qui ne reflète pas la nature financière du système.
Il s’agit d’un modèle interne Coinbase, pas d’un nouveau standard universel de notation.
150 000 scans depuis le milieu de l’année
Coinbase publie plusieurs chiffres sur l’utilisation actuelle de CAT.
Depuis mi-2026, la plateforme aurait effectué plus de 150 000 scans sur son environnement de production.
Plus de 128 000 de ces opérations concernaient des revues de pull requests.
Coinbase affirme également que le nombre de findings de pentest corrigés chaque mois a fortement progressé depuis que ses équipes offensives ont commencé à utiliser des outils IA fin 2025.
La société ne publie cependant pas dans cette annonce suffisamment de données sur faux positifs, faux négatifs ou sévérité moyenne pour transformer cette augmentation en comparaison scientifique avec le pentest traditionnel.
Ces chiffres démontrent surtout une différence d’échelle et de fréquence.
Le coût des modèles devient lui-même une contrainte de sécurité
Appliquer les modèles les plus coûteux à chaque commit et chaque repository pourrait rapidement devenir économiquement absurde.
Coinbase dit contrôler ce problème avec des budgets maximums par scan, du prompt caching agressif et une sélection du modèle adaptée au workload.
Une revue légère n’a donc pas nécessairement besoin du même budget qu’une analyse profonde d’un chemin d’exploitation complexe.
C’est un aspect important de la généralisation des agents : le facteur limitant peut devenir non plus la capacité du modèle, mais le prix nécessaire pour l’exécuter partout.
Les humains conservent les enquêtes les plus difficiles
Coinbase insiste sur le fait que CAT n’est pas présenté comme un remplacement de l’équipe offensive.
La plateforme prend en charge la couverture répétitive et les analyses de grande largeur afin que les chercheurs puissent passer davantage de temps sur la threat modeling, les nouvelles classes d’attaque et les investigations multi-étapes.
Pour ces cas, CAT possède un mode Live Operative.
L’agent et l’ingénieur travaillent alors sur la même cible. Le système peut proposer des scénarios adversariaux, mais l’opérateur peut les approuver, les modifier ou rediriger l’analyse.
Les mêmes règles d’engagement externes continuent de borner les actions réellement autorisées.
Coinbase doit maintenant tester les agents qui testent le reste
Le prochain problème est presque récursif.
Si CAT dépend de modèles probabilistes, une mise à jour du modèle ou du prompt peut modifier la qualité de détection.
Coinbase construit donc un système d’évaluation destiné à comparer les sorties des agents à des datasets dont les résultats attendus sont déjà connus.
L’objectif est de pouvoir déterminer si un changement améliore réellement la détection au lieu de supposer qu’un modèle plus récent est automatiquement meilleur.
À mesure que SHADE étend sa couverture, Coinbase travaille également sur un moteur de priorité chargé de décider quels actifs méritent le plus de ressources de test.
Le pentest devient moins un rendez-vous et davantage un état permanent
L’idée la plus intéressante de CAT n’est finalement pas d’utiliser l’IA pour trouver une injection ou un contrôle d’accès défaillant.
Des équipes de sécurité utilisent déjà des modèles dans ce type de travail.
Le changement est la cadence.
Un pentest traditionnel produit une photographie relativement profonde d’un périmètre à un instant précis.
Une plateforme continue essaie de traiter chaque nouvelle modification comme une raison potentielle de refaire une partie de cette photographie immédiatement.
La faiblesse de cette approche est évidente : automatiser davantage donne davantage de pouvoir aux outils qui commettent eux-mêmes des erreurs.
Coinbase répond en séparant donc très clairement intelligence et autorité.
L’agent peut raisonner comme un attaquant. Il peut chercher un chemin, proposer une commande et contester un résultat.
Mais lorsqu’il faut réellement toucher la production, c’est toujours du code déterministe hors du modèle qui décide jusqu’où il a le droit d’aller.