 Par Tsuky
Les assistants vocaux savent répondre à une question. Ils ont souvent davantage de difficultés à suivre une conversation. Il suffit parfois d'un bref acquiescement pour provoquer un silence inattendu. Une interruption peut être ignorée, ou le système peut attendre trop longtemps avant de comprendre que son interlocuteur a terminé. Ces problèmes semblent secondaires lorsqu'on utilise une IA pour obtenir une information ponctuelle. Ils deviennent beaucoup plus gênants lorsqu'on souhaite discuter pendant plusieurs minutes. C'est précisément le domaine auquel s'attaque Shizuku AI, une entreprise japonaise travaillant sur les personnages conversationnels et les AI VTubers. Le 8 novembre 2026, ses chercheurs ont dévoilé Shizuku-Duplex, un modèle vocal conçu pour dialoguer en japonais avec un rythme plus proche de celui d'une conversation humaine.
Le full-duplex change la manière dont une IA participe à une conversation
De nombreux assistants vocaux reposent historiquement sur un fonctionnement séquentiel. L'utilisateur parle. Le système détecte la fin de son intervention, reconnaît les mots prononcés, produit une réponse, puis convertit cette réponse en parole. Cette architecture peut être décrite comme une succession de traitements : reconnaissance vocale, modèle de langage et synthèse audio. Elle fonctionne correctement pour une question courte suivie d'une réponse. Mais elle impose souvent une séparation artificielle entre celui qui parle et celui qui écoute.
Le full-duplex modifie cette logique. Le modèle reçoit des informations vocales pendant qu'il produit lui-même de l'audio. Il peut donc continuer à surveiller son interlocuteur, même lorsqu'il a commencé sa réponse. Cette propriété rend possibles plusieurs comportements plus naturels. Un utilisateur peut ajouter une précision sans attendre un silence complet. Il peut interrompre une réponse devenue inutile. Il peut aussi prononcer un simple acquiescement sans que l'IA considère automatiquement qu'une nouvelle question vient de commencer.
La distinction est importante : un système full-duplex n'est pas simplement un chatbot auquel on a ajouté une synthèse vocale plus rapide. Il doit également décider à quel moment parler, à quel moment écouter et comment interpréter les interventions qui se superposent. Cette gestion du rythme conversationnel constitue l'une des contributions principales de Shizuku-Duplex.
80 millisecondes : une cadence interne, pas une réponse instantanée
Le chiffre mis en avant par Shizuku AI est particulièrement court : 80 millisecondes. Mais il doit être correctement interprété. L'architecture de Shizuku-Duplex fonctionne par cycles successifs, appelés ticks. À chaque cycle, le modèle reçoit des informations sur la voix de l'utilisateur et produit les éléments nécessaires à sa propre sortie. Le traitement d'un cycle doit être effectué dans une fenêtre de 80 millisecondes pour préserver le fonctionnement en temps réel.
Cela ne signifie pas qu'une question reçoit une réponse complète en 80 millisecondes. Le modèle peut avoir besoin de plusieurs cycles pour comprendre une demande, déterminer quand commencer à parler et produire son intervention. Les opérations externes, comme une recherche sur le web, peuvent également prendre plusieurs secondes. La cadence interne et la latence de réponse mesurent donc deux phénomènes distincts.
Les chercheurs indiquent avoir utilisé des optimisations d'inférence, notamment TensorRT et des noyaux de calcul Triton, pour respecter cette contrainte temporelle. Ces technologies permettent d'optimiser certaines opérations exécutées sur les processeurs graphiques. L'objectif est de réduire suffisamment le temps de traitement pour que le système puisse recevoir et produire des fragments audio sans interrompre le dialogue. Shizuku AI ne publie cependant pas une fiche complète permettant de déduire les performances sur toutes les configurations matérielles.
570 millisecondes pour répondre après la fin d'une intervention
Le blog technique fournit une autre mesure, beaucoup plus directement liée à l'expérience utilisateur. Dans les évaluations publiées, Shizuku-Duplex commence à répondre après un délai médian de 0,57 seconde suivant la fin de la prise de parole. GPT-Live-1 atteint 0,53 seconde dans le protocole présenté par l'équipe. La différence est donc faible sur cette mesure particulière.
Les auteurs rapportent également 1,27 seconde pour Gemini 3.8 Live et 1,61 seconde pour GPT-Realtime-2.1. Ces comparaisons exigent toutefois de la prudence. Shizuku-Duplex et GPT-Live ont été évalués à partir d'enregistrements côté serveur, sans inclure le temps de parcours réseau. Pour GPT-Realtime et Gemini Live, les chercheurs ont utilisé une méthode fondée sur la lecture locale, qui inclut une partie du délai réseau. Les conditions ne sont donc pas parfaitement identiques.
Le classement obtenu ne doit pas être transformé en affirmation selon laquelle Shizuku-Duplex serait systématiquement plus rapide que les autres services sur tous les appareils. La latence ressentie par l'utilisateur dépend également de la connexion, du traitement audio, de la charge des serveurs et de l'application employée. Le résultat montre avant tout que l'équipe a obtenu une cadence conversationnelle compétitive dans son environnement de test.
Les interruptions constituent l'un de ses meilleurs résultats
Un interlocuteur humain peut s'arrêter immédiatement lorsqu'on lui signale qu'une explication n'est plus nécessaire. Pour un modèle vocal, ce comportement est plus compliqué qu'il n'y paraît. Le système doit détecter une intervention pendant sa propre production audio, déterminer si elle s'adresse réellement à lui, puis décider de poursuivre ou de s'arrêter.
Dans les évaluations publiées par Shizuku AI, le modèle cesse de parler dans les deux secondes suivant une interruption dans 89 % des cas. GPT-Live-1 obtient 82 % dans le même tableau de résultats. Le modèle japonais présente également un comportement intéressant lorsqu'un utilisateur prononce simplement un son d'acquiescement. Dans 95 % des scénarios correspondants, il continue à parler au lieu de s'arrêter inutilement.
Ces deux résultats décrivent des situations différentes. Une véritable interruption doit généralement conduire le système à écouter. Un simple « oui » ou « hum » peut au contraire indiquer que l'utilisateur suit la conversation et souhaite laisser l'IA poursuivre. Confondre ces signaux rend les échanges artificiels. Shizuku-Duplex cherche précisément à mieux faire cette distinction.
Les tests révèlent également des faiblesses importantes
Les résultats ne sont pas tous favorables au nouveau modèle. Shizuku AI rapporte notamment que son système répond trop souvent à des paroles qui ne lui sont pas destinées. Dans les scénarios où l'utilisateur s'adresse à une autre personne, Shizuku-Duplex déclenche une réponse dans 83 % des cas. Pour les paroles provenant de l'arrière-plan, cette proportion atteint 75 %.
Ce sont des performances problématiques. Un assistant vocal destiné à rester actif doit pouvoir distinguer une demande qui lui est adressée d'une conversation voisine. À défaut, il risque d'intervenir sans invitation. Cette difficulté devient particulièrement importante dans un foyer, un bureau ou une pièce où plusieurs personnes parlent simultanément.
Shizuku AI ne cache pas ces mesures dans son tableau. Elles montrent qu'un système capable de réagir efficacement aux interruptions n'est pas nécessairement capable d'identifier correctement toutes les situations où il devrait rester silencieux. La naturalité d'une conversation dépend autant de la capacité à parler au bon moment que de la capacité à ne pas parler inutilement.
Un modèle d'interaction rapide et un second modèle pour réfléchir
L'architecture repose sur une séparation entre deux fonctions. Le premier modèle, appelé interaction model, est responsable du dialogue en temps réel. Il reçoit les informations vocales, détermine les interventions possibles et produit la parole destinée à l'utilisateur. Le second, appelé background model, traite les demandes nécessitant davantage de calcul ou l'utilisation d'outils externes.
Cette séparation permet de poursuivre la conversation pendant qu'une tâche plus complexe s'exécute. L'exemple publié par Shizuku AI concerne l'organisation d'un voyage à Kyoto. L'utilisateur demande des recommandations compatibles avec un budget donné. Le modèle d'interaction identifie qu'une recherche externe serait utile et émet un jeton spécial nommé DELEGATE. Ce jeton transmet la demande au modèle d'arrière-plan.
Pendant que ce dernier effectue sa recherche web, le premier modèle peut continuer à parler. Il peut reconnaître la demande, expliquer qu'il recherche des informations ou poursuivre un échange pertinent. Une fois le résultat obtenu, le contenu est réinjecté dans la conversation et le modèle peut formuler sa réponse détaillée. L'exemple technique présente une recherche durant 7,1 secondes. Le système ne transforme pas cette opération en calcul instantané. Il évite plutôt que toute la conversation reste bloquée pendant son exécution.
Cette architecture est particulièrement intéressante pour les agents vocaux. Elle sépare la fluidité de l'interaction des tâches qui nécessitent une réflexion plus longue ou un accès à des services externes.
Un dialogue produit simultanément de l'audio, du texte et des actions
Le cœur de Shizuku-Duplex repose sur un Transformer construit autour d'un modèle de langage. La voix de l'utilisateur est transformée en caractéristiques audio par un encodeur capable de traiter le flux progressivement. Ces informations sont combinées avec les sorties du cycle précédent. Le modèle produit ensuite plusieurs catégories de données.
La première correspond à des tokens audio qui sont convertis en signal sonore. La deuxième est un contenu textuel interne, présenté dans la documentation sous le nom Inner Monologue. Ce texte prépare le contenu verbal légèrement avant sa production audio. Il ne s'agit pas d'une transcription publique d'un raisonnement privé exhaustif, mais d'une représentation textuelle utilisée dans le processus de génération.
La troisième catégorie concerne les actions. Un module dédié peut sélectionner des mouvements associés aux intentions ou à l'expression du personnage. Cette fonction vise notamment l'animation d'avatars Live2D. Le système ne produit donc pas seulement une voix : il est conçu pour coordonner des éléments de dialogue et d'animation.
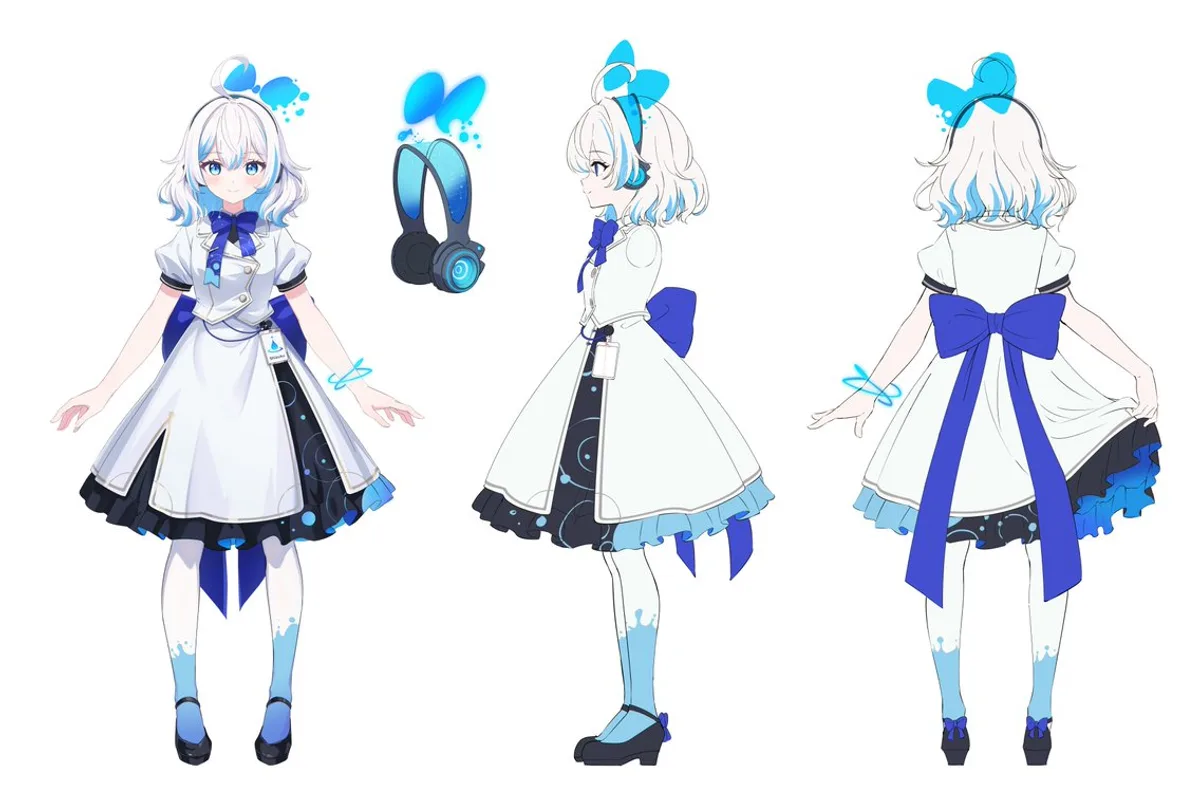
Le personnage Shizuku illustre l'objectif de l'entreprise : développer des avatars conversationnels associant voix, comportement et animation. Le visuel ne représente pas un schéma de l'architecture du modèle.
Pourquoi Shizuku AI utilise un personnage virtuel
Le projet de Shizuku AI ne poursuit pas exactement le même objectif que les assistants principalement destinés à répondre à des questions pratiques. L'entreprise travaille sur Shizuku, un personnage conversationnel capable d'interagir avec son public. Dans ce contexte, la qualité du dialogue dépend également de sa mise en scène. Une hésitation, un acquiescement ou une réaction à une interruption peuvent contribuer à donner une impression de continuité.
Les AI VTubers combinent généralement une représentation animée avec des systèmes capables de produire du contenu et de réagir aux interactions. Shizuku AI veut approfondir ce modèle. Sa documentation évoque l'ambition de créer un compagnon conversationnel qui paraisse présent tout au long des échanges. Cette impression reste un objectif de conception. Elle ne démontre pas que le système possède une conscience, des sentiments ou une compréhension humaine de la relation.
La distinction est importante lorsqu'une technologie est destinée à être utilisée régulièrement comme compagnon virtuel. La fluidité de la voix peut rendre une interaction plus convaincante sans garantir la fiabilité des informations ni la pertinence de toutes les réponses.
GPT-Live conserve un avantage notable sur la qualité du contenu
Les comparaisons publiées montrent que Shizuku-Duplex rivalise sur plusieurs paramètres de gestion de la conversation. La situation est différente lorsqu'on examine la qualité des réponses. Pour les échanges informels en japonais, le modèle obtient un score de pertinence de 6,5 sur 10, contre 8,5 pour GPT-Live-1. La naturalité du contenu atteint 6,2 contre 7,6.
La précision des réponses à plusieurs tours atteint 79 % pour Shizuku-Duplex et 95 % pour GPT-Live-1. Sur les questions nécessitant une recherche web, les résultats sont de 43 % et 50 % respectivement. Ces chiffres illustrent la distinction entre fluidité et compétence. Une IA peut prendre son tour de parole de manière très naturelle tout en donnant une réponse incomplète ou incorrecte.
Shizuku AI présente son modèle comme le deuxième meilleur système full-duplex de sa comparaison pour la qualité des réponses, derrière GPT-Live. Il ne s'agit cependant pas d'un classement indépendant de l'ensemble du marché. Les évaluations ont été préparées par les développeurs et utilisent leurs propres scénarios japonais.
Les auteurs expliquent s'être inspirés de plusieurs benchmarks existants, mais reconnaissent que les données publiques permettant de comparer ce type de modèles en japonais sont limitées. Une partie des réponses a été transcrite automatiquement, puis évaluée avec Claude Opus 5.5 comme juge. Cette méthode introduit des dépendances au modèle évaluateur, aux instructions employées et aux jeux de tests retenus. La publication ne constitue donc pas une validation externe définitive des classements.
Un mécanisme de compression pour éviter que les longues conversations se dégradent
Les conversations prolongées représentent un autre défi technique. Dans un système full-duplex, le flux d'informations se poursuit même lorsque personne ne formule une phrase complète. Le contexte peut donc grossir rapidement. À mesure qu'il augmente, le modèle doit conserver suffisamment d'informations pour répondre de manière cohérente.
Shizuku AI indique avoir introduit un mécanisme de compression automatique, ou auto-compaction. Environ toutes les cinq minutes, le système résume une partie de l'historique et reconstruit le contexte avec les informations jugées pertinentes. L'objectif est d'éviter une augmentation continue de la quantité de données conservées dans la fenêtre de conversation.
Selon les développeurs, le passage au nouveau contexte s'effectue sans interruption audible. Cette approche possède néanmoins une limite conceptuelle. Résumer une conversation implique de sélectionner certaines informations et d'en éliminer d'autres. Un détail devenu important plus tard pourrait ne pas avoir été conservé. La publication ne fournit pas de garantie de mémoire parfaite ni d'évaluation indépendante couvrant toutes les durées de conversation.
Le mécanisme vise donc à préserver la continuité des échanges, sans éliminer complètement les risques d'oubli ou de déformation du contexte.
Une publication technique, pas encore une API publique confirmée
Shizuku AI a publié une description détaillée de son architecture et plusieurs démonstrations vocales. Le modèle est présenté comme fonctionnel dans l'environnement développé par l'équipe. En revanche, cette annonce ne fournit pas de confirmation suffisante concernant une API générale accessible aux développeurs externes.
Elle ne documente pas non plus une distribution publique des poids du modèle sous une licence permettant de l'héberger librement. Aucun tarif commercial ni calendrier de disponibilité générale n'est établi dans le billet technique du 8 novembre. Il serait donc prématuré de présenter Shizuku-Duplex comme un service disponible immédiatement pour toutes les applications tierces.
L'équipe prévoit de poursuivre les travaux sur ses capacités de dialogue. Elle annonce également une orientation vers la prise en charge d'informations visuelles et vers de nouvelles langues. Ces développements constituent une feuille de route, et non des fonctionnalités déjà démontrées dans la version décrite.
Le prochain défi est de savoir quand ne pas répondre
Les performances de Shizuku-Duplex montrent qu'une partie de la difficulté des agents vocaux se situe désormais dans le rythme des conversations. La rapidité de génération ne suffit pas. Il faut savoir interrompre une phrase, reconnaître un acquiescement et laisser suffisamment d'espace à son interlocuteur.
Sur ces points, les résultats publiés par Shizuku AI sont encourageants. Le modèle atteint des performances proches de GPT-Live sur la latence médiane mesurée, et ses tests de gestion des interruptions montrent plusieurs progrès par rapport aux modèles japonais comparés.
Mais ses difficultés à ignorer les paroles de l'arrière-plan rappellent une autre exigence essentielle : un assistant qui écoute continuellement doit aussi comprendre quand il n'est pas concerné. La qualité des réponses, la robustesse dans les environnements bruyants et la publication de tests indépendants restent des points déterminants.
Shizuku-Duplex constitue ainsi une démonstration technique intéressante de dialogue japonais en full-duplex, plutôt qu'une preuve qu'un personnage virtuel peut déjà converser sans erreur comme un humain. Les 80 millisecondes décrivent une cadence de calcul. La réussite du projet dépendra surtout de tout ce que le système parvient à faire entre ces cycles : écouter correctement, répondre utilement et respecter le rythme de son interlocuteur.