
 Par Adri
Le prochain Snapdragon premium n'a pas encore livré tous ses secrets, mais Qualcomm vient d'en dévoiler une partie essentielle : son CPU.
La nouvelle génération Oryon peut atteindre 5 GHz sur ses cœurs les plus rapides. Qualcomm la présente comme le premier CPU mobile à franchir cette fréquence. Le constructeur insiste toutefois sur un point presque immédiatement après avoir affiché le chiffre : la fréquence n'est qu'une partie du problème.
Un cœur à 5 GHz qui attend ses données reste un cœur qui attend.
5 GHz sur un smartphone n'est pas simplement une histoire de gravure
Qualcomm explique avoir conçu lui-même la microarchitecture, les choix d'implémentation et le sous-système CPU afin de pousser Oryon jusque-là dans l'enveloppe d'un SoC mobile.
Le constructeur associe cette fréquence à l'IPC, les instructions exécutées par cycle. Multiplier les cycles n'est réellement utile que si suffisamment de travail peut être effectué à chacun d'eux et si les données nécessaires arrivent assez vite.
C'est précisément là qu'intervient la hiérarchie mémoire.
Chaque cœur Oryon dispose d'un important cache L1 d'instructions, tandis qu'un cache L2 reste placé directement dans le complexe CPU. Pour cette nouvelle génération mobile, Qualcomm ajoute une architecture supplémentaire baptisée Oryon Flex Cache.
Flex Cache casse les frontières rigides entre cœurs
Qualcomm décrit Flex Cache comme un pool accessible par des cœurs hétérogènes et dont la capacité est distribuée dynamiquement selon le workload.
Cela change la manière de penser un cache partagé. Au lieu qu'une charge lourde soit limitée à une quantité prédéterminée alors qu'une autre partie du cache reste peu exploitée ailleurs dans le CPU, les cœurs Prime peuvent puiser davantage dans le pool lorsqu'ils en ont besoin.
L'objectif est de maintenir un working set important dans le CPU aussi longtemps que possible avant de devoir l'expulser vers la mémoire système.
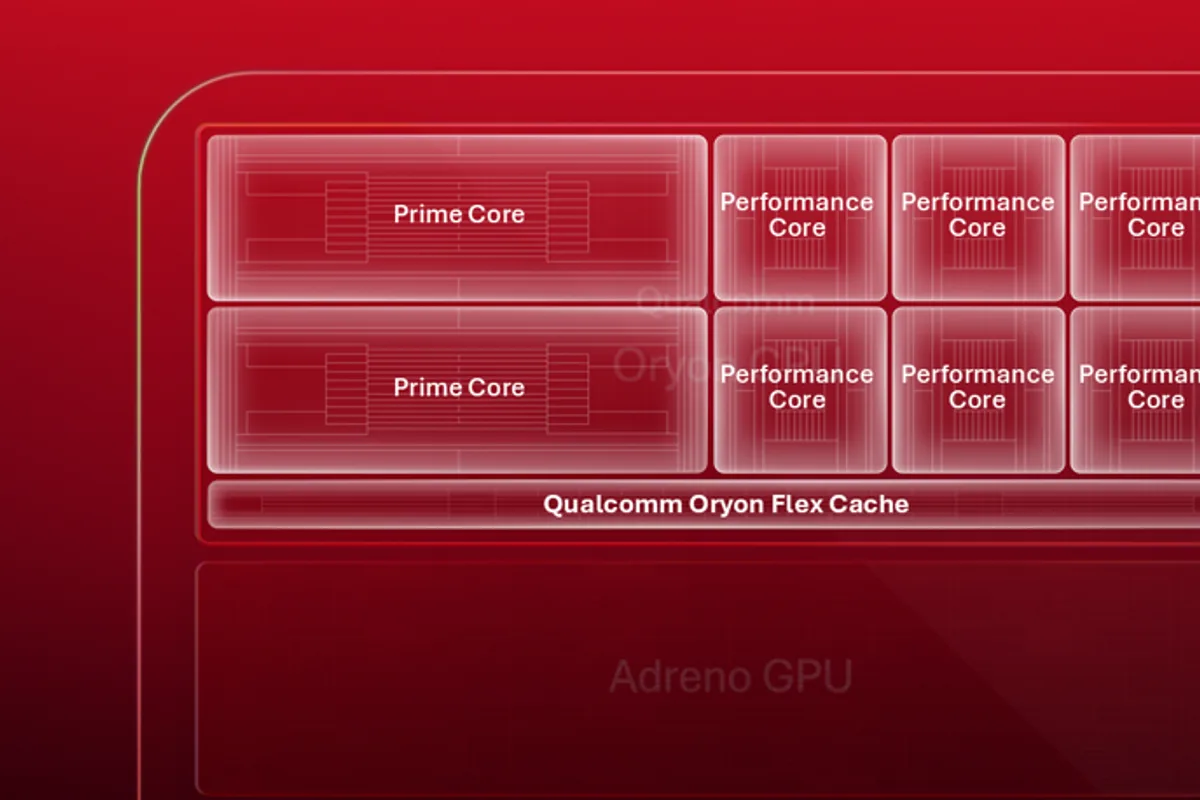
Qualcomm ne donne pas encore la capacité exacte de ce Flex Cache dans cette présentation. Impossible donc de comparer sérieusement son volume avec les caches des futurs concurrents uniquement à partir de cette annonce.
Le fonctionnement décrit est déjà plus intéressant que le nombre de mégaoctets : le constructeur cherche à rendre l'allocation moins statique.
Pourquoi un cache raté coûte si cher sur mobile
Un CPU consulte d'abord ses caches parce qu'ils sont proches et rapides. Lorsque la donnée recherchée n'y est plus, il doit descendre dans la hiérarchie mémoire jusqu'à la DRAM.
Cet accès est beaucoup plus coûteux en latence. Il faut aussi déplacer les données sur le SoC et activer davantage de circuits, ce qui a un prix énergétique.
Sur un PC de bureau, quelques watts supplémentaires peuvent parfois être absorbés par un gros refroidissement et une alimentation généreuse. Un smartphone possède une surface de dissipation minuscule et fonctionne sur batterie.
Réduire les accès mémoire n'est donc pas seulement une optimisation de performances. C'est aussi une manière de limiter le travail effectué par le reste du système.
Le déplacement d'une tâche entre deux cœurs est précisément le scénario difficile
Les SoC mobiles utilisent plusieurs types de cœurs parce qu'un seul design n'est pas idéal pour toutes les tâches. Une charge peut commencer sur un cœur, grossir, être déplacée vers un cœur plus puissant puis revenir ailleurs quelques instants plus tard.
Sans mécanisme adapté, cette migration peut obliger le nouveau cœur à recharger des données qu'un autre venait déjà de manipuler.
Qualcomm veut que Flex Cache limite ce redémarrage à froid. Les différents cœurs travaillent à partir du même pool, ce qui augmente les chances que les données nécessaires restent localement disponibles lorsque l'ordonnanceur déplace le travail.
Le bénéfice potentiel ne vient donc pas seulement d'un accès plus rapide. Il vient aussi de ce qu'on évite de jeter puis de récupérer.
Le jeu est un bon exemple parce que ses working sets ne restent pas tranquilles
Un jeu moderne fait travailler en permanence logique, simulation, moteur physique, audio, réseau et préparation des commandes graphiques. Le CPU ne traite pas une petite fonction isolée puis s'endort.
Qualcomm affirme que son accès au cache doit aider à stabiliser les fréquences d'images et à limiter les chutes et micro-saccades lorsque de gros ensembles de données circulent entre les cœurs.
Cela ne signifie pas que Flex Cache garantira de meilleurs 1 % low sur tous les jeux. Il faudra mesurer de vrais appareils, avec leurs limites thermiques, leurs pilotes et leurs politiques d'ordonnancement.
L'architecture attaque néanmoins un problème crédible : une fréquence CPU élevée perd rapidement son intérêt lorsque le pipeline attend la mémoire.
Le multitâche profite du même principe pour une raison différente
Lorsque l'utilisateur passe d'une application à l'autre, le système déplace continuellement des processus entre états actifs, arrière-plan et reprise.
Si les données encore utiles restent dans un cache accessible au nouveau cœur chargé de l'application, la reprise peut éviter une partie des accès à la mémoire système.
Qualcomm cite explicitement ce scénario, ainsi que le montage vidéo. Décodage, effets et export peuvent se transmettre des frames à travers plusieurs étapes et plusieurs cœurs.
Ici encore, la promesse de Flex Cache est de garder davantage de ce travail dans le voisinage immédiat du CPU.
L'IA agentique rend l'organisation du CPU plus importante, pas moins
Les présentations récentes de smartphones ont tendance à réduire l'IA à leur NPU. Qualcomm décrit une architecture beaucoup plus hétérogène.
Un agent peut faire tourner un modèle sur le NPU tout en laissant le CPU gérer la planification, les appels d'outils, les entrées-sorties, certaines branches de logique et le passage d'une étape à la suivante.
Une requête unique peut donc devenir une série d'opérations différentes, exécutées successivement et parfois déplacées entre plusieurs cœurs.
Qualcomm présente Flex Cache comme une réponse à ce comportement : conserver le dataset disponible pendant ces handoffs au lieu de repartir en mémoire à chaque transition.
Le 5 GHz apporte du débit à un thread rapide. Flex Cache cherche plutôt à empêcher le reste du workflow de casser ce rythme.
Le point critique reste la DRAM du smartphone
La mémoire système mobile a énormément progressé, mais elle reste une ressource partagée entre CPU, GPU, NPU, ISP et autres blocs du SoC.
Chaque accès évité libère donc potentiellement de la bande passante pour un autre moteur. C'est particulièrement intéressant au moment où les constructeurs ajoutent des modèles IA plus lourds sans pouvoir augmenter indéfiniment la quantité de RAM ou sa consommation.
Qualcomm relie d'ailleurs explicitement Flex Cache aux contraintes actuelles de mémoire. Un working set qui reste dans le cache ne monopolise pas la DRAM de la même manière.
5 GHz ne répond toujours pas à la question de la performance soutenue
Une fréquence maximale décrit un état de fonctionnement, pas la durée pendant laquelle un smartphone peut le conserver.
Qualcomm n'a pas encore publié dans cette présentation les données nécessaires pour juger la consommation à 5 GHz, les températures, la fréquence en charge longue ou la capacité exacte du nouveau cache.
C'est particulièrement important sur mobile. Un CPU capable d'un pic très élevé pendant quelques secondes et un CPU capable de conserver une grande partie de ses performances pendant vingt minutes ne racontent pas la même histoire.
Les premiers smartphones permettront de mesurer cela correctement.
Le nom du futur Snapdragon reste lui aussi à venir
Qualcomm parle pour l'instant de sa prochaine plateforme Snapdragon premium sans donner son nom commercial définitif dans cette présentation CPU.
Le constructeur dévoile progressivement les blocs de l'architecture avant Snapdragon Summit 2026. Le GPU et le NPU font partie de la même stratégie, avec une attention croissante portée à la proximité des données et aux accélérateurs spécialisés.
Le CPU résume assez bien cette évolution. Le chiffre facile à retenir est 5 GHz. La modification architecturale la plus révélatrice est un cache conçu pour empêcher ces 5 milliards de cycles par seconde de passer trop de temps à attendre la mémoire.