
 Par Tsuky
Une intelligence artificielle capable de répondre à une question en quelques secondes n'est pas nécessairement capable de terminer un travail complexe. Pour corriger un problème dans une application, elle doit parfois lire plusieurs fichiers, rechercher une erreur, modifier du code, exécuter des tests et recommencer si le résultat échoue. Chaque étape consomme du temps et des tokens. Et lorsque plusieurs agents travaillent ensemble, la facture peut augmenter rapidement. C'est précisément le marché que MiniMax cherche à conquérir. Le groupe chinois a lancé officiellement M3.1 Flash le 19 octobre 2026. Contrairement à une présentation centrée uniquement sur la conversation, l'annonce insiste sur les tâches où le modèle doit agir : programmation, utilisation d'ordinateur, automatisation de services professionnels et analyse de cybersécurité. MiniMax revendique une inférence presque trois fois plus rapide que celle de son modèle précédent. L'entreprise affirme également avoir réduit de 70 % le coût global des tâches agentiques. Ces deux chiffres constituent les arguments commerciaux majeurs du lancement. Mais ils viennent du fabricant. Ils doivent donc être distingués d'une amélioration confirmée indépendamment dans tous les environnements.
Pourquoi la vitesse devient essentielle pour les agents IA
Lorsqu'on utilise un assistant conversationnel, quelques secondes supplémentaires peuvent sembler acceptables. Dans un environnement agentique, le problème est différent. Un agent peut devoir appeler un modèle plusieurs dizaines de fois pour terminer une mission. Il commence par comprendre la demande. Il recherche ensuite les informations nécessaires, choisit des outils et exécute une première série d'actions. Il doit parfois vérifier son travail, corriger une erreur ou effectuer une nouvelle recherche. Une réduction du temps de réponse à chaque étape peut donc se répercuter sur toute la durée de la mission. MiniMax annonce des vitesses de sortie pouvant dépasser 200 tokens par seconde dans certains scénarios courants. L'entreprise mentionne aussi un débit médian supérieur à 170 tokens par seconde. C'est un niveau élevé pour des usages nécessitant beaucoup de génération de texte. Mais la vitesse de sortie ne mesure pas à elle seule le temps total nécessaire pour terminer une tâche. Un agent dépend également de la latence des outils qu'il appelle, de la quantité d'informations à analyser et du nombre de corrections nécessaires. Un modèle rapide qui multiplie les erreurs peut finalement coûter plus cher qu'un modèle plus lent mais fiable. C'est pourquoi les performances doivent être évaluées sur des missions complètes, et pas seulement sur le nombre de tokens générés chaque seconde.
Des tarifs très agressifs pour les développeurs
La grille tarifaire officielle de M3.1 Flash mérite l'attention. MiniMax annonce 0,15 dollar par million de tokens envoyés au modèle. Les tokens générés sont facturés 0,60 dollar par million. La lecture d'informations déjà présentes dans le cache bénéficie d'un tarif réduit à 0,015 dollar par million de tokens d'entrée. Pour comprendre ce que cela signifie, imaginons une application qui envoie dix millions de tokens et reçoit deux millions de tokens en réponse. Avec ces prix, et sans autre poste de facturation, les tokens d'entrée représenteraient 1,50 dollar. Les tokens générés coûteraient 1,20 dollar. La consommation totale correspondrait donc à 2,70 dollars. Il s'agit d'un exemple arithmétique fondé sur la grille publiée, pas d'une mesure de coût réel sur une mission professionnelle. Les workflows d'agents incluent souvent d'autres dépenses. Il peut s'agir du temps d'exécution des outils, des serveurs, des recherches en ligne ou des appels à des services tiers. La facturation dépend aussi de la quantité de contexte réutilisée et des éventuels mécanismes de cache. MiniMax estime que le coût global des tâches agentiques diminue de 70 % par rapport à son modèle précédent. Cette affirmation porte sur les conditions de ses évaluations. Elle ne permet pas de promettre une baisse de 70 % sur la facture de toutes les entreprises.
Le vrai indicateur : le prix d'une tâche correctement terminée
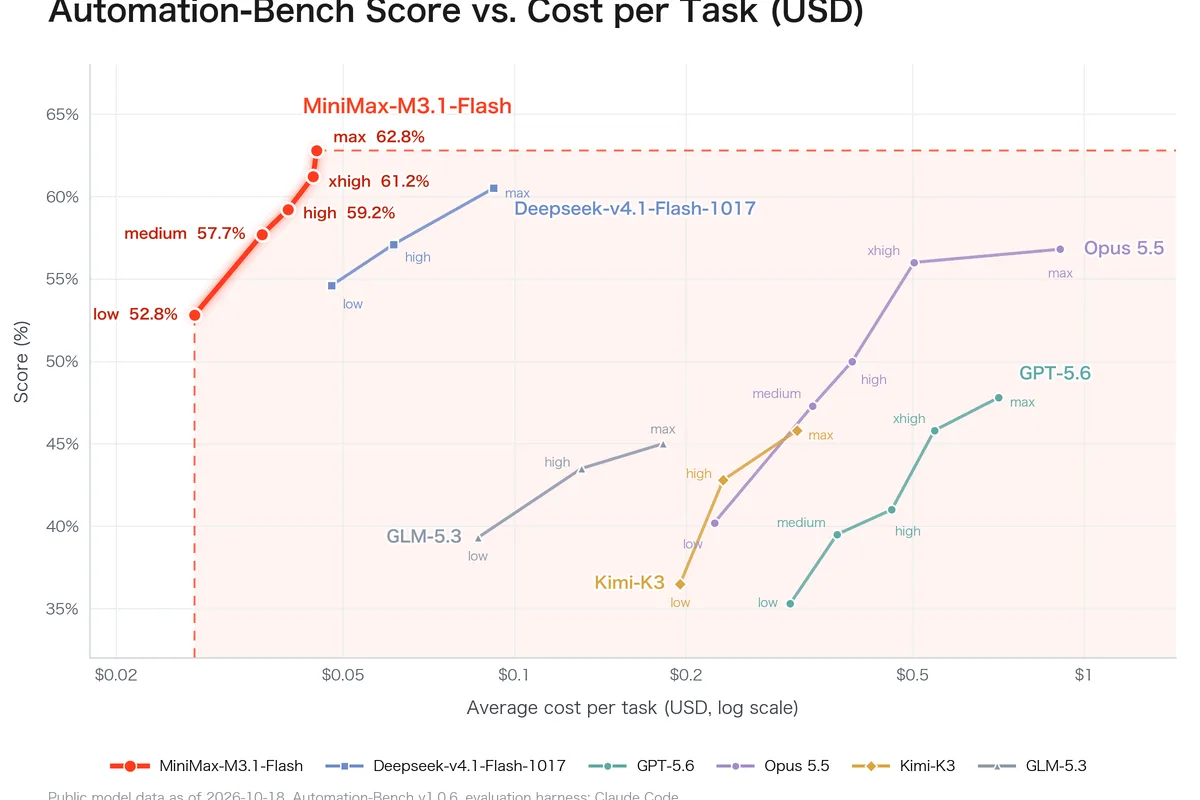
Les fabricants de modèles mettent souvent en avant le prix du million de tokens. Cette information est utile, mais elle peut être trompeuse lorsqu'on compare des intelligences artificielles de capacités différentes. Prenons deux modèles chargés de corriger une erreur logicielle. Le premier facture peu chaque token, mais échoue plusieurs fois avant de produire une solution correcte. Le second coûte davantage à chaque appel, mais termine la mission dès sa première tentative. Le modèle apparemment le moins cher peut alors être le plus coûteux en pratique. MiniMax a précisément choisi de comparer les performances et le coût par tâche dans plusieurs de ses graphiques. L'entreprise utilise notamment Automation-Bench pour des missions professionnelles et DeepSWE pour le développement logiciel. Elle cherche à montrer que M3.1 Flash se rapproche de modèles plus coûteux tout en consommant moins de budget pour atteindre un résultat. La démarche est pertinente. Mais l'interprétation nécessite de comprendre les paramètres. Les résultats peuvent varier selon le niveau d'effort du modèle, le logiciel agentique qui l'utilise, les outils autorisés et les conditions exactes d'évaluation. Un graphique performances-prix ne constitue donc pas une garantie universelle. Il fournit un point de comparaison dans un environnement défini.
73,7 % sur DeepSWE : MiniMax vise les développeurs
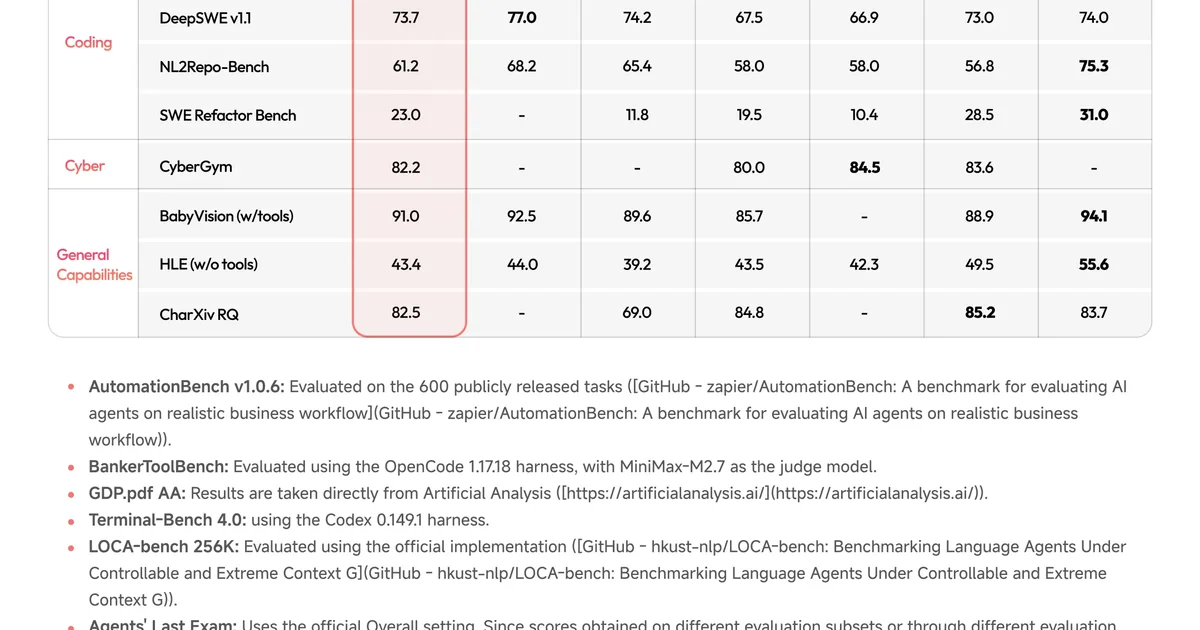
Parmi les chiffres publiés, le résultat sur DeepSWE v1.1 retient particulièrement l'attention. MiniMax annonce un taux de réussite de 73,7 %. Cette évaluation porte sur des tâches de développement logiciel où l'IA doit comprendre une base de code, réaliser des modifications et vérifier le résultat. Le modèle ne se contente donc pas de compléter quelques lignes. Il doit maintenir la cohérence de son travail à travers plusieurs opérations. Pour un développeur, la différence est importante. Une IA capable de proposer un fragment de code peut faire gagner quelques minutes. Un agent capable de résoudre de manière fiable un problème entier pourrait transformer l'organisation du travail. Toutefois, réussir une proportion importante de tests standardisés ne signifie pas qu'un modèle peut gérer seul toutes les applications professionnelles. Les dépôts réels contiennent des dépendances complexes, des conventions propres aux équipes et des contraintes qui n'apparaissent pas toujours dans les benchmarks. La qualité du résultat doit donc être vérifiée. MiniMax n'a pas démontré qu'un développeur pourrait abandonner les revues de code ou les tests automatisés en utilisant M3.1 Flash. L'intérêt du modèle se trouve plutôt dans son potentiel pour accélérer certaines tâches sous supervision.
Une IA qui peut aussi utiliser un ordinateur
La programmation n'est pas la seule cible de M3.1 Flash. MiniMax met en avant les capacités de Computer Use. Le principe consiste à permettre au modèle d'interagir avec un environnement informatique. Un agent peut observer une interface, décider d'une action, utiliser des outils et poursuivre son travail en fonction du résultat. Cette approche ouvre des possibilités pour les tâches répétitives. Une entreprise peut vouloir que son assistant consulte des documents, rassemble des données ou prépare un dossier dans plusieurs applications. Un utilisateur peut souhaiter automatiser une série d'opérations qui nécessitent habituellement de passer d'un logiciel à un autre. MiniMax annonce un score de 61,7 sur OSWorld V2, un benchmark consacré à l'utilisation d'ordinateur. L'entreprise publie également 29,6 sur Agents' Last Exam, qui examine des missions professionnelles. Ces chiffres montrent les performances revendiquées dans les environnements retenus par les évaluations. Ils ne prouvent pas que le modèle peut utiliser n'importe quel logiciel sans erreur. Les interfaces changent. Les fenêtres apparaissent à des endroits différents. Certaines opérations présentent des conséquences financières ou peuvent modifier des données importantes. Pour de tels usages, il est préférable d'encadrer les autorisations et de conserver des étapes de validation humaine.
La cybersécurité devient un autre argument commercial
MiniMax accorde aussi une place notable à la cybersécurité. L'entreprise annonce un résultat d'environ 82 % sur CyberGym. Ce benchmark évalue certaines capacités liées aux vulnérabilités logicielles et à leur reproduction dans des environnements définis. Le fabricant indique que M3.1 Flash peut assister les spécialistes pour examiner du code, identifier des faiblesses, préparer des corrections et analyser des programmes suspects. Il évoque également des travaux de rétro-ingénierie et de tests de sécurité. L'automatisation peut aider à traiter des volumes de code importants. Mais elle pose deux difficultés. La première concerne la précision. Un modèle peut signaler une vulnérabilité inexistante ou manquer un problème réel. La deuxième concerne les usages abusifs. Des capacités utiles pour la défense peuvent aussi faciliter certaines recherches offensives. La publication d'un score élevé sur CyberGym ne suffit pas à établir qu'un système est sûr dans toutes les situations. MiniMax mentionne également des évaluations internes. Celles-ci restent distinctes d'un audit indépendant complet. Dans un contexte professionnel, les analyses de cybersécurité produites par une IA doivent donc rester vérifiées par des personnes qualifiées.
La parcimonie permet de réduire le travail effectué par le modèle
Comment MiniMax explique-t-il ses gains de vitesse ? L'entreprise met en avant une utilisation plus agressive de la parcimonie pendant l'inférence. Dans un modèle d'intelligence artificielle, toutes les opérations ne contribuent pas nécessairement de manière égale au calcul d'une réponse. Les architectures dites parcimonieuses cherchent à limiter certaines dépenses de calcul en sélectionnant les éléments réellement utiles au traitement. La famille MiniMax M3 utilisait déjà des techniques d'attention parcimonieuse pour gérer de longs contextes. M3.1 Flash poursuit cette orientation. L'objectif est de faire davantage de travail avec une quantité de ressources informatiques mieux maîtrisée. Cette stratégie est particulièrement intéressante lorsque le modèle doit être appelé de nombreuses fois. Pour autant, les gains annoncés ne doivent pas être attribués à un seul élément architectural sans données supplémentaires. Les performances d'un service en ligne dépendent également du matériel, de l'optimisation logicielle et de l'infrastructure utilisée. La publication de MiniMax présente un résultat global. Elle ne fournit pas une démonstration indépendante permettant d'isoler précisément la contribution de chaque optimisation.
Space Bunny : MiniMax révèle l'identité d'un modèle testé anonymement
Le lancement apporte également une information intéressante sur les évaluations publiques des modèles. MiniMax confirme que Space Bunny, apparu précédemment sur OpenRouter sans identité officielle clairement annoncée, était une version préliminaire de M3.1 Flash. Ce genre de diffusion permet à un fabricant de faire essayer un modèle avant de révéler son nom commercial. Les réactions peuvent donner des indications sur son comportement dans des usages variés. Mais elles ne remplacent pas un protocole de test contrôlé. MiniMax affirme que Space Bunny a traité plus de 200 000 milliards de tokens pendant cette période. Le volume est considérable. Il ne permet cependant pas de connaître directement le nombre d'utilisateurs uniques, la nature de tous les travaux effectués ou le taux de réussite réel du modèle. Un grand nombre de tokens peut provenir d'essais répétés, de tâches longues ou de workflows très automatisés. La révélation confirme surtout que MiniMax avait déjà exposé une version préliminaire de son modèle à des utilisateurs avant le lancement officiel. Le produit annoncé le 19 octobre n'est donc pas apparu sans aucune période d'expérimentation préalable.
Un million de tokens de contexte, mais pas des capacités illimitées
La documentation de la version préliminaire de M3.1 Flash décrit une fenêtre de contexte pouvant atteindre un million de tokens. Elle indique également une prise en charge de contenus textuels, d'images et de vidéos en entrée. Ces fonctions s'inscrivent dans l'orientation de la famille M3, conçue pour traiter des informations longues et diverses. Pour un développeur, un contexte étendu peut faciliter l'analyse de plusieurs fichiers ou documents. Pour un agent professionnel, il peut permettre de conserver davantage d'informations pendant une mission. Mais une fenêtre de contexte importante n'équivaut pas à une compréhension parfaite de son contenu. La qualité peut varier selon la position des informations, leur complexité et les outils employés. Traiter un long document ne garantit pas d'en extraire chaque détail correctement. La prise en charge de vidéos en entrée ne signifie pas non plus que M3.1 Flash est un modèle spécialisé dans la génération de vidéos. Il faut distinguer les modalités que le modèle peut analyser de celles qu'il peut produire. Enfin, des entrées volumineuses peuvent augmenter la consommation et les temps de traitement. Le coût réel d'une tâche dépend donc toujours de la quantité d'informations transmise.
Le modèle est disponible, mais les poids ne sont pas encore ouverts
MiniMax annonce une disponibilité immédiate de M3.1 Flash par trois canaux. Les développeurs peuvent utiliser son API. Les abonnés M Plan peuvent y accéder dans le cadre de leur offre. Le modèle est également proposé dans MiniMax Code, l'environnement de développement de la société. En revanche, les poids de M3.1 Flash ne sont pas disponibles au téléchargement dans l'annonce officielle du 19 octobre. MiniMax indique qu'ils seront publiés plus tard. Cette distinction est essentielle. Un modèle accessible par API n'est pas nécessairement un modèle que l'on peut installer sur ses propres serveurs. L'utilisation en ligne suppose de transmettre des requêtes à l'infrastructure du fournisseur, dans les conditions prévues par son service. Pour les entreprises qui traitent du code confidentiel ou des documents sensibles, les règles de conservation et de traitement des données restent importantes. Il faut également examiner la disponibilité géographique, les conditions commerciales et les éventuelles limites d'usage. MiniMax annonce enfin un modèle Pro destiné à repousser davantage les capacités de sa gamme. Aucune disponibilité immédiate de cette future version ne peut être déduite de cette annonce.
Une concurrence centrée sur le rapport performances-prix
L'annonce de M3.1 Flash intervient dans un marché où les modèles spécialisés dans la programmation et les agents se multiplient. Le prix des tokens n'est plus le seul argument. Les développeurs comparent aussi la vitesse, la capacité à utiliser des outils, le taux de réussite et le coût d'exécution d'une tâche complète. SiliconANGLE relève notamment que le prix d'entrée de M3.1 Flash est compétitif face à certaines offres Flash de DeepSeek. Le média souligne cependant que les scores annoncés par différents fabricants ne sont pas tous vérifiés indépendamment. Des différences de configuration peuvent aussi rendre les comparaisons difficiles. Il est donc excessif de déclarer un vainqueur universel en se fondant seulement sur une présentation commerciale. Les besoins varient considérablement. Une entreprise qui utilise un agent pour classer des documents ne recherche pas nécessairement les mêmes propriétés qu'une équipe développant une application complexe. La cybersécurité, le support client et l'automatisation administrative imposent encore d'autres contraintes. La question pratique consiste à mesurer le coût total pour une tâche donnée, avec les mêmes critères de qualité. C'est là que MiniMax devra confirmer les gains qu'il revendique.
Ce que les entreprises devront tester avant d'adopter M3.1 Flash
Pour une équipe qui utilise déjà des agents IA, la nouvelle offre mérite une comparaison concrète. Il faut d'abord sélectionner des missions représentatives du travail quotidien. Elles peuvent inclure la correction de bogues, l'analyse de documents, la préparation de rapports ou l'exécution de procédures internes. Chaque mission devrait être évaluée selon plusieurs critères. Le temps d'exécution total compte. Le taux de réussite est essentiel. Les interventions humaines nécessaires doivent également être mesurées. Enfin, il faut inclure tous les coûts, pas seulement la génération de tokens. Un modèle bon marché qui oblige à refaire une partie du travail peut perdre son avantage. À l'inverse, un modèle très rapide et suffisamment fiable peut permettre d'automatiser davantage de tâches pour un budget équivalent. Les entreprises doivent aussi examiner la confidentialité des données, les accès aux outils et la possibilité d'interrompre ou de corriger une action. C'est particulièrement important pour les agents capables de modifier des fichiers, d'utiliser des comptes ou de prendre des décisions qui ont des conséquences réelles. Les démonstrations publiques sont utiles pour découvrir un produit. Elles ne remplacent pas un test sur les propres workflows de l'entreprise.
MiniMax cherche à rendre l'IA agentique économiquement viable
M3.1 Flash ne se distingue pas uniquement par l'annonce d'un nouveau score sur un benchmark. Son lancement révèle une direction importante du marché. Les modèles d'intelligence artificielle ne sont plus seulement évalués selon la qualité de leurs réponses. Ils sont de plus en plus jugés sur leur capacité à terminer des missions. Cette évolution donne une valeur particulière à la rapidité et aux dépenses de calcul. MiniMax promet précisément de réduire les deux. Le prix de 0,15 dollar par million de tokens en entrée est concret. La disponibilité via l'API et MiniMax Code est confirmée. Les gains de vitesse proches d'un facteur trois, la baisse de coût de 70 % et les performances aux benchmarks restent des résultats annoncés par l'éditeur. Leur portée réelle devra être établie sur des tâches indépendantes et des environnements variés. La publication future des poids sera également un élément à suivre. Pour l'instant, le modèle est une nouvelle option disponible pour les développeurs qui souhaitent comparer les performances et le coût de leurs agents. Son intérêt ne se résume pas à savoir s'il répond plus vite qu'un concurrent. Il se mesurera à la fréquence avec laquelle il parvient à terminer correctement une tâche, sans multiplier les appels inutiles ni transférer le travail de vérification à l'utilisateur. C'est sur ce terrain que la promesse de MiniMax devra être jugée.