 Par Adri
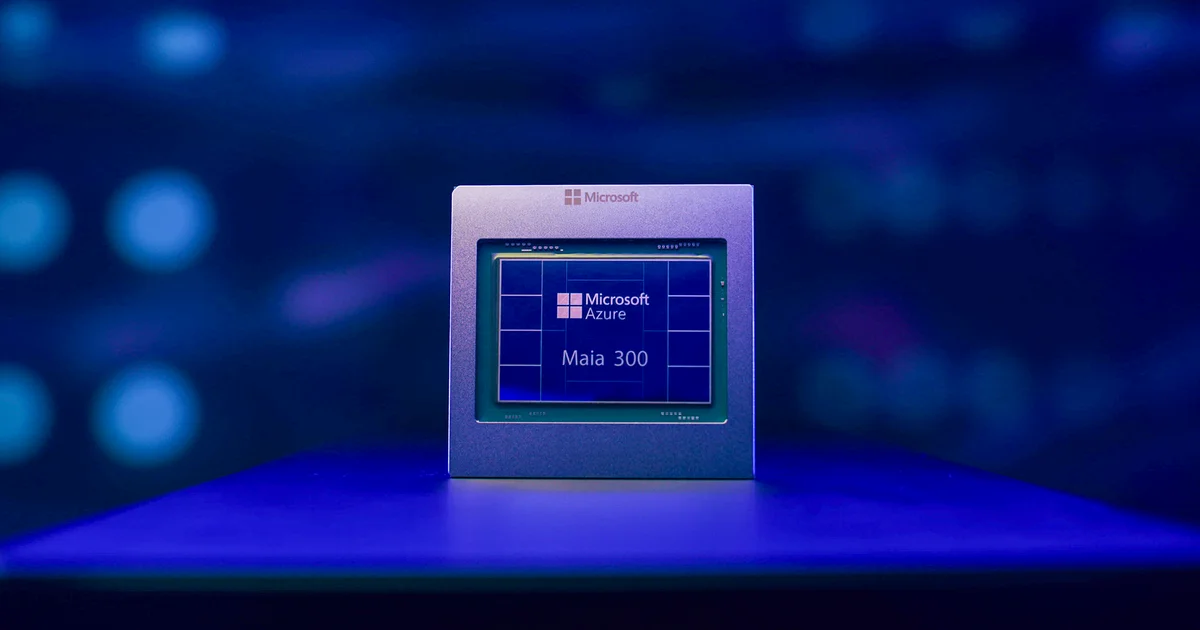
La guerre des accélérateurs IA ne se joue plus uniquement entre Nvidia et AMD. Leurs plus gros clients commencent eux aussi à concevoir des alternatives, avec un avantage difficile à reproduire : ils savent exactement quelles tâches leurs propres services exécutent. Microsoft compte exploiter cette connaissance avec Azure Maia 300, sa troisième génération d'accélérateurs développés en interne.
Présentée le 12 octobre, la nouvelle puce n'est pas encore un produit déployé à grande échelle. Microsoft prévoit ses premières installations en production en 2027 et annonce une extension de la famille Maia à des infrastructures représentant plusieurs gigawatts. L'objectif affiché est de faire de cette plateforme le principal système d'inférence de ses produits et services. Il s'agit donc d'une feuille de route ambitieuse, pas d'une migration déjà achevée.
Le choix de l'inférence est central. Entraîner un grand modèle et exécuter quotidiennement ses réponses ne sollicitent pas les machines de la même manière. Dans un service comme Copilot, chaque interaction mobilise de la mémoire, déplace des données et consomme de l'énergie. Multipliées par des millions d'utilisateurs, de modestes améliorations de rendement peuvent représenter des économies considérables.
Une architecture qui ne cherche pas seulement la puissance brute
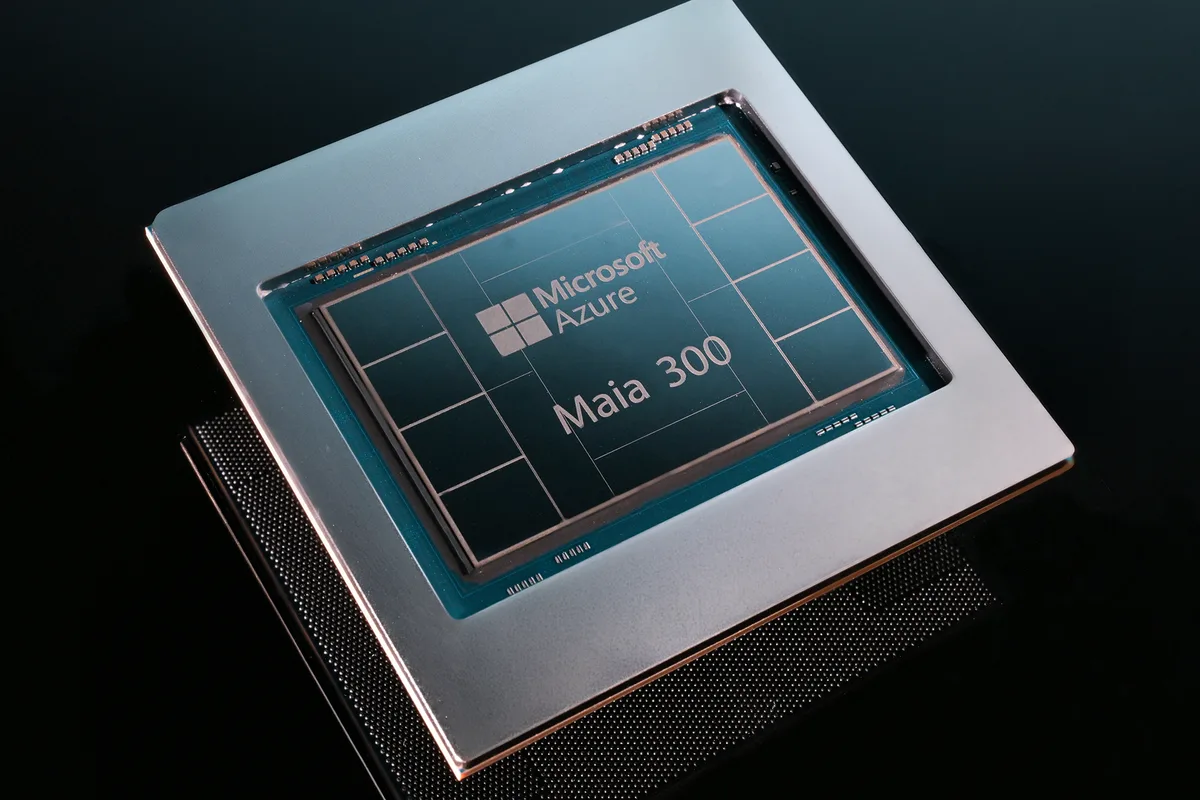
Maia 300 adopte une organisation en chiplets : plusieurs éléments spécialisés composent le processeur au lieu de confier toutes les fonctions à une seule grande puce. Les composants de calcul utilisent le procédé N2P de TSMC, appartenant à la famille des technologies de fabrication dites de classe 2 nm. D'autres fonctions, notamment liées aux échanges de données, reposent sur des composants distincts.
Cette conception traduit une priorité : éviter que les unités de calcul attendent inutilement leurs données. Microsoft explique que le déplacement de l'information entre les différentes mémoires, les accélérateurs et le réseau devient un facteur limitant pour les grands systèmes d'inférence. Augmenter simplement le nombre d'opérations théoriques par seconde ne suffit plus.
Le constructeur met donc en avant une architecture de circulation des données définie par logiciel, des optimisations de noyaux de calcul et une meilleure coordination des ressources. Sur le papier, cette approche doit augmenter la part d'énergie effectivement consacrée à produire des réponses plutôt qu'à déplacer des données.
18 To/s de bande passante mémoire : pourquoi la HBM4 compte autant
Maia 300 embarque huit piles de mémoire HBM4, pour une bande passante maximale annoncée de 18 To/s. Son enveloppe thermique atteint 950 W. Ces deux chiffres résument le défi auquel Microsoft s'attaque : alimenter rapidement des modèles de plus en plus gourmands en mémoire tout en maîtrisant l'énergie consommée.
La mémoire HBM est placée au plus près des unités de calcul afin de fournir un débit très élevé. Pour les modèles travaillant sur de longs contextes et les traitements faisant intervenir de nombreux tokens, cette bande passante peut devenir déterminante. Des accélérateurs très puissants mais insuffisamment alimentés en données risquent de perdre une partie de leur intérêt pratique.
Microsoft ajoute la prise en charge de formats de calcul à précision réduite, notamment une version améliorée de MXFP4. La réduction de la précision numérique permet, dans les situations adaptées, de diminuer les volumes de données à stocker et à déplacer. Elle impose néanmoins de contrôler les compromis sur la qualité des résultats selon les modèles et les tâches.
Il serait donc trompeur de résumer Maia 300 à son procédé de fabrication. La gravure représente une partie de l'équation. L'organisation de la mémoire, le logiciel et le réseau comptent tout autant dans le rendement d'un système complet.
96 accélérateurs et 167 kW : Microsoft raisonne désormais à l'échelle du rack
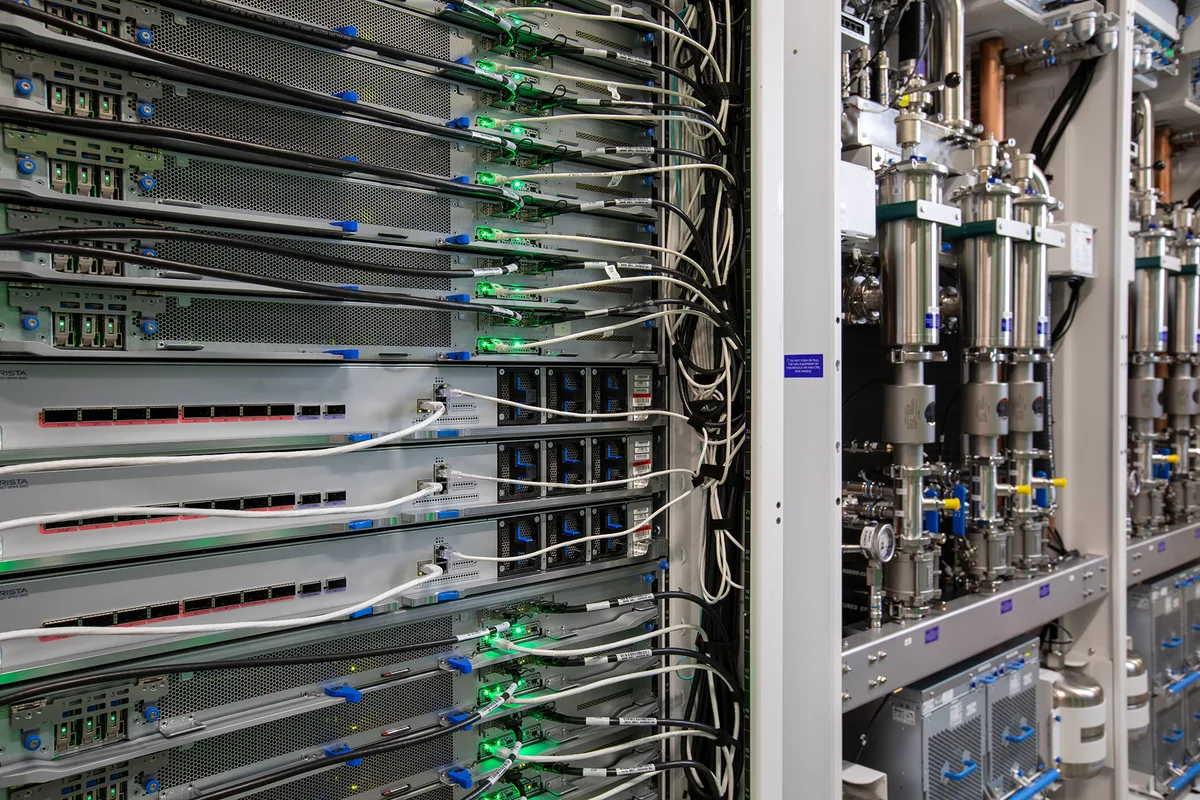
La configuration complète présentée par Microsoft rassemble 96 accélérateurs dans un rack consommant environ 167 kW. L'ensemble dispose de 27,6 To de mémoire HBM et d'une bande passante mémoire agrégée annoncée de 1,7 Po/s.
Ces valeurs illustrent un changement d'échelle. Un accélérateur isolé peut afficher des caractéristiques impressionnantes sans pour autant offrir le meilleur coût d'exploitation. Dans un centre de données, il faut aussi considérer la manière dont des dizaines de processeurs communiquent, la puissance électrique disponible, le refroidissement et la capacité à maintenir les machines occupées.
Microsoft décrit ainsi un réseau spécialisé reposant sur des technologies Ethernet et des interconnexions à haut débit. Il doit permettre de répartir des opérations entre accélérateurs et racks tout en limitant les surcoûts liés aux communications.
Cette densité pose évidemment une autre question : 167 kW ne constituent pas une consommation anodine. Même avec un meilleur rendement par token, une infrastructure de plusieurs gigawatts reste extrêmement exigeante en électricité et en refroidissement. Une amélioration d'efficacité ne signifie pas automatiquement une diminution de la consommation totale lorsque la capacité installée augmente fortement.
40 % de tokens supplémentaires par mégawatt : une promesse à contextualiser
Microsoft revendique un gain de 40 % en tokens produits par mégawatt face à des systèmes reposant sur les principaux GPU du marché. Le chiffre est important pour comprendre la stratégie du groupe : il porte sur le travail effectivement accompli à puissance électrique comparable, plutôt que sur une performance théorique isolée.
Une réserve s'impose. Microsoft n'identifie pas publiquement avec suffisamment de précision les configurations GPU servant de référence à cette comparaison. Le modèle exécuté, la longueur du contexte, le nombre de requêtes simultanées et les conditions de mesure peuvent pourtant modifier fortement le résultat.
Le constructeur avance également un débit de tokens par rack jusqu'à sept fois supérieur à celui de Maia 200, ainsi qu'une performance par watt dépassant 2,5 fois celle de la génération précédente selon sa présentation technique. Là encore, il faut lire précisément les conditions de comparaison : la nouvelle configuration augmente notamment le nombre d'accélérateurs par rack. Un gain de débit par rack ne représente pas nécessairement une multiplication identique de la puissance de chaque puce.
Ces annonces constituent des objectifs de performance et des résultats communiqués par Microsoft, pas des mesures indépendantes réalisées sur des systèmes commerciaux accessibles. La confrontation avec des plateformes Nvidia ou AMD dans des charges identiques restera indispensable pour établir un classement crédible.
Maia 200 travaille déjà, Maia 300 doit encore faire ses preuves
La stratégie de Microsoft repose sur plusieurs générations de matériel. Maia 200 exécute déjà des charges en production, notamment pour Copilot et les travaux de l'équipe Microsoft AI. Le groupe indique que des modèles OpenAI, ses propres modèles MAI et des modèles ouverts fonctionnent sur cette infrastructure.
Microsoft annonce une extension à d'autres services, notamment GitHub Copilot et Microsoft Foundry. Les besoins visés sont variés : génération de code, conversations nécessitant une faible latence, traitement de longs contextes et agents capables d'enchaîner plusieurs actions.
Maia 300 a été conçu à partir de cette expérience opérationnelle, mais son déploiement en production ne doit commencer qu'en 2027. Il faut donc distinguer les performances actuellement observées sur Maia 200 des caractéristiques et gains annoncés pour son successeur.
Cette distinction empêche aussi de conclure trop vite que tous les clients Azure basculeront sur Maia. Microsoft continue de proposer une infrastructure hétérogène et ses partenaires externes peuvent avoir besoin d'environnements GPU différents. Le développement d'une puce interne n'élimine pas automatiquement la demande pour les accélérateurs Nvidia.
Le véritable enjeu : conserver une plus grande part de la valeur créée par l'IA
L'intérêt économique devient plus clair à mesure que l'usage des assistants augmente. Chaque abonnement et chaque appel à un modèle engendrent des coûts d'exploitation. Lorsque le fournisseur du service achète l'essentiel de ses capacités à des fabricants tiers, une partie importante de la valeur créée remonte vers ces fournisseurs.
Concevoir son propre accélérateur permet à Microsoft de rechercher un meilleur équilibre entre coût matériel, consommation électrique et besoins réels de ses applications. Cela lui donne également davantage de contrôle sur son calendrier industriel, même si l'entreprise reste dépendante de partenaires comme TSMC pour la fabrication et de chaînes d'approvisionnement complexes pour la mémoire avancée.
Reuters rapporte que Microsoft envisage un déploiement potentiellement supérieur à un million de puces Maia 300 en 2027. Une telle ambition donne la mesure de l'investissement envisagé, mais ne doit pas être confondue avec une commande entièrement exécutée ou un volume déjà livré.
À court terme, Nvidia conserve des avantages substantiels : un vaste écosystème logiciel, des GPU polyvalents et une implantation massive dans l'entraînement comme dans l'inférence. Maia 300 ne remet pas instantanément cet ensemble en cause. Microsoft cherche plutôt à réduire sa dépendance sur les tâches qu'il connaît le mieux et qu'il exécute lui-même à très grande échelle.
Une bataille de rendement plus que de prestige
Le lancement de Maia 300 raconte finalement quelque chose de plus profond qu'une nouvelle puce gravée avec une technologie récente. Dans l'IA industrielle, la performance n'est plus seulement une question de puissance maximale. Elle devient un problème d'architecture complète, de disponibilité électrique et de coût par résultat utile.
Si Microsoft atteint ses objectifs, il pourra absorber davantage de demandes sur ses propres infrastructures et négocier autrement sa place dans l'écosystème des accélérateurs. Mais tant que Maia 300 n'aura pas démontré ses performances en production et fait l'objet de comparaisons indépendantes, la prudence reste de mise.
La date à retenir est donc 2027. C'est à partir des premiers déploiements réels que l'on pourra juger si Microsoft a créé une alternative économiquement solide pour une partie de ses charges IA, ou simplement présenté une architecture prometteuse dans un secteur où les annonces techniques vont souvent plus vite que les installations.