 Par Tsuky
Un développeur qui utilise un modèle d'intelligence artificielle pour chaque opération de son application peut rapidement découvrir un problème inattendu. Son projet fonctionne, les résultats semblent convaincants, mais la facture augmente beaucoup plus vite que le nombre de clients. La raison est parfois simple : il utilise un modèle très puissant pour des opérations qui ne demandent presque aucun raisonnement. Extraire une date d'une facture, classer un ticket de support ou reformater un document ne nécessite pas nécessairement la même intelligence qu'identifier un bug complexe dans plusieurs dépôts de code. C'est le point de départ du guide consacré à GPT-6 qu'OpenAI a publié le 2 octobre 2026. Plutôt que d'annoncer une nouvelle capacité spectaculaire, l'entreprise présente une méthode pour choisir ses modèles, organiser les instructions et construire des applications capables de fonctionner durablement. Le sujet intéressera surtout les équipes qui ont dépassé le stade de la démonstration technique. Faire fonctionner une intelligence artificielle une fois est devenu relativement accessible. La faire fonctionner des milliers de fois, à un coût prévisible et avec des résultats contrôlables, reste beaucoup plus difficile.
Trois modèles, trois niveaux de prix très différents
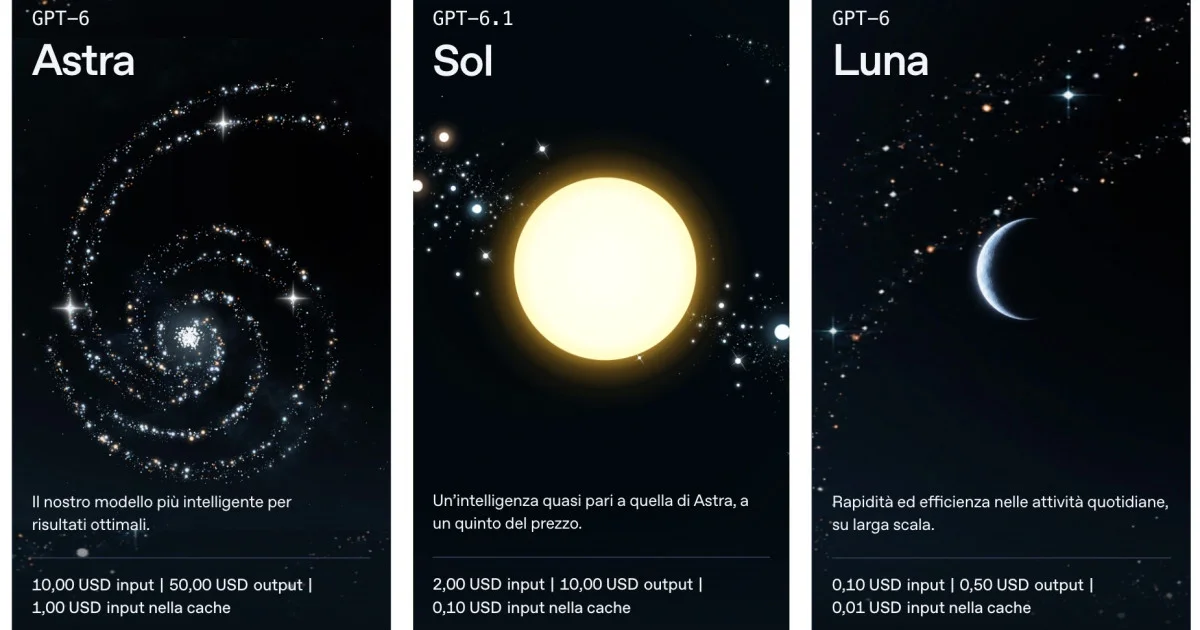
La famille GPT-6 présentée par OpenAI couvre plusieurs besoins. GPT-6 Astra occupe le sommet de la gamme. Il est destiné aux tâches nécessitant les capacités de raisonnement les plus avancées : développement logiciel particulièrement complexe, recherches difficiles ou opérations impliquant de nombreuses décisions interdépendantes. GPT-6.1 Sol vise un compromis entre capacités élevées et coût plus raisonnable. OpenAI le recommande notamment pour le développement logiciel, les recherches approfondies et les travaux informatiques complexes. GPT-6 Luna se concentre sur les opérations plus ciblées et répétitives, réalisées potentiellement en très grand nombre. La différence apparaît immédiatement dans les tarifs annoncés. Pour un million de tokens en entrée, Astra coûte 10 dollars, GPT-6.1 Sol 2 dollars et Luna 0,10 dollar. En sortie, les prix correspondants sont de 50 dollars, 10 dollars et 0,50 dollar par million de tokens. Sur ces deux catégories tarifaires, Luna est donc cent fois moins cher qu'Astra. Mais ce rapport de prix ne signifie pas qu'une application complète utilisant Luna coûtera systématiquement cent fois moins cher. Un modèle économique qui se trompe plus souvent, multiplie les tentatives ou mobilise davantage d'outils peut finalement coûter davantage qu'une option plus puissante. Le prix du token constitue une information importante. Il ne suffit pas à calculer la rentabilité réelle d'une application.
La véritable unité de mesure devient la tâche réussie
OpenAI recommande de mesurer trois éléments avant un déploiement en production : la qualité des résultats, la latence et le coût. Ces mesures doivent être examinées ensemble. Imaginons une application chargée de lire des documents et d'en extraire des informations structurées. Un modèle très économique peut traiter chaque document à faible prix. Mais s'il produit régulièrement des erreurs, l'entreprise devra financer des corrections, des validations humaines ou de nouvelles requêtes. À l'inverse, utiliser Astra pour chaque extraction peut représenter un coût excessif si Luna fournit déjà des résultats suffisamment fiables. La bonne méthode consiste à construire un ensemble de tests représentatifs, puis à comparer les différents modèles sur les mêmes tâches. Il faut compter les réponses exploitables, les erreurs, les reprises et le temps d'exécution. Le critère décisif devient le coût par résultat acceptable. Cette logique change la manière de choisir une intelligence artificielle. Il ne s'agit plus d'acheter systématiquement le modèle obtenant les meilleurs scores dans les évaluations générales, mais de sélectionner celui qui répond aux exigences précises d'un produit.
L'effort de raisonnement devient un paramètre économique
Le choix du modèle ne représente qu'une partie de l'optimisation. OpenAI recommande également d'ajuster le niveau de raisonnement utilisé pendant l'exécution. Une opération simple peut fonctionner avec un effort faible. Une tâche nécessitant plusieurs arbitrages peut justifier un niveau intermédiaire. Les problèmes difficiles, comme certains diagnostics logiciels, peuvent bénéficier d'un raisonnement plus approfondi. Les niveaux disponibles varient selon le modèle et les fonctionnalités utilisées. L'idée générale consiste à éviter de mobiliser des ressources coûteuses lorsque le problème ne les exige pas. Cette recommandation semble évidente. Elle est pourtant facile à négliger dans une application conçue autour d'un seul modèle et d'une configuration fixe. Un développeur peut être tenté de choisir le niveau maximal pour obtenir les meilleures réponses possibles. Mais davantage de raisonnement signifie potentiellement plus de tokens, plus de temps et une facture plus élevée. Le gain doit donc être démontré sur la tâche concernée. OpenAI recommande également de tester les différents modes de vitesse, notamment Fast et Ultrafast lorsqu'ils sont disponibles. Ces options peuvent réduire la latence, mais elles peuvent appliquer des conditions tarifaires différentes. La vitesse maximale n'est pas nécessairement rentable pour une opération qui peut être exécutée en arrière-plan.
Le cache devient une véritable stratégie d'architecture
L'un des passages les plus importants du guide concerne le prompt caching. Dans une application professionnelle, de nombreuses requêtes partagent les mêmes éléments : instructions générales, définitions d'outils, documents de référence ou règles métier. Ces informations peuvent être envoyées à répétition au modèle. Sans mécanisme adapté, une partie du travail informatique nécessaire pour les traiter doit être renouvelée à chaque demande. Le cache permet de réutiliser certains préfixes de contexte déjà traités. OpenAI indique que les tokens d'entrée éligibles peuvent bénéficier de réductions atteignant 95 % selon le modèle et les conditions applicables. Le guide recommande de placer les informations stables avant les données spécifiques à chaque demande. Cette organisation augmente les possibilités de réutilisation. À l'inverse, modifier constamment les instructions générales ou l'ordre des outils peut réduire l'efficacité du cache. La conséquence est intéressante : la structure d'un prompt devient une décision d'architecture logicielle. Deux applications utilisant le même modèle peuvent présenter des coûts sensiblement différents simplement parce qu'elles n'organisent pas leurs contextes de la même manière. Il faut cependant distinguer les tokens réellement réutilisés de l'ensemble des tokens envoyés. Une réduction maximale sur une catégorie ne garantit pas une réduction identique de la facture totale.
Compacter les conversations plutôt que conserver tout l'historique
Les agents destinés au développement logiciel ou aux recherches approfondies peuvent travailler pendant de longues périodes. Au fil des opérations, ils accumulent des instructions, des réponses d'outils, des extraits de fichiers et des décisions intermédiaires. Conserver intégralement cet historique peut devenir coûteux. Le guide recommande d'utiliser la compaction, un mécanisme destiné à réduire la quantité de contexte nécessaire tout en préservant les informations indispensables pour poursuivre le travail. L'objectif n'est pas d'effacer arbitrairement les étapes précédentes. Un agent doit conserver la trace des décisions structurantes, des contraintes et des résultats déjà obtenus. Mais il n'a pas toujours besoin de relire chaque message ou chaque détail technique pour effectuer l'action suivante. Cette distinction devient particulièrement importante dans les grands projets logiciels. Un agent peut avoir analysé plusieurs dizaines de fichiers, exécuté des tests et corrigé différentes erreurs. Lorsqu'il passe à une nouvelle étape, il doit disposer d'un état fiable du travail plutôt que d'une transcription exhaustive de toute son activité. La compaction constitue donc un outil d'efficacité, à condition de préserver correctement les informations critiques. Une synthèse incomplète peut provoquer des oublis ou des décisions incohérentes. Son utilisation doit être évaluée avec autant de soin que les autres composants de l'application.
OpenAI recommande de simplifier les prompts devenus trop complexes
Voici peut-être la recommandation la plus surprenante du document. Pendant plusieurs années, les utilisateurs avancés ont appris à rédiger des instructions extrêmement détaillées pour obtenir des résultats fiables. Les prompts ont parfois accumulé des dizaines de règles, des exemples nombreux et des prescriptions expliquant précisément chaque étape à suivre. Selon OpenAI, cette méthode peut devenir contre-productive avec des modèles plus capables. Eric Provencher, membre de l'équipe Developer Experience de l'entreprise, explique que les modèles comprennent mieux les nuances et les ambiguïtés. Des instructions excessivement prescriptives peuvent ainsi gêner un raisonnement qui fonctionnerait mieux avec davantage de latitude. Le guide recommande de définir clairement la mission, le résultat attendu, les contraintes et les critères permettant de considérer le travail comme terminé. Il ne demande pas de supprimer toutes les règles. La distinction porte sur leur utilité. Une contrainte indispensable à la sécurité ou à l'exactitude doit rester explicite. En revanche, une procédure artificiellement longue, conçue pour compenser les limites d'une ancienne génération de modèles, peut mériter d'être réévaluée. OpenAI invite notamment les développeurs à revoir les fichiers AGENTS.md et les skills utilisés dans leurs environnements de développement. Ces documents peuvent accumuler des instructions contradictoires ou redondantes au fil des évolutions d'un projet. Les simplifier revient parfois à améliorer le comportement de l'agent sans changer de modèle.
Donner davantage d'autonomie exige de définir des limites
Les agents GPT-6 sont conçus pour accomplir des opérations de plus en plus complexes. Un système peut analyser un dépôt de code, modifier des fichiers, exécuter des tests et poursuivre son travail en fonction des résultats obtenus. Mais une autonomie mal définie peut produire deux problèmes opposés. L'agent peut interrompre son travail pour demander une validation sur chaque détail, ce qui annule une grande partie de l'intérêt de l'automatisation. Ou il peut prendre des décisions importantes sans autorisation suffisante. OpenAI recommande de distinguer explicitement les actions pouvant être exécutées indépendamment de celles nécessitant une confirmation. Un agent de développement peut, par exemple, être autorisé à effectuer des tests locaux sur des données jetables. Cela ne signifie pas qu'il devrait recevoir automatiquement le droit de modifier une base de données de production ou de supprimer des ressources importantes. Les limites doivent être adaptées à l'environnement et au niveau de risque. Le guide insiste également sur la définition de ce que signifie terminer une tâche. Modifier un fichier ne suffit pas nécessairement. Il peut falloir exécuter les tests, examiner les résultats, corriger les erreurs et vérifier que les conditions initiales sont respectées. Cette conception transforme les instructions en contrat opérationnel plutôt qu'en simple demande conversationnelle.
Les appels asynchrones empêchent les agents de rester bloqués
L'exécution prolongée des tâches constitue un autre sujet central. Dans une application classique, un appel à un outil peut bloquer la progression du processus en attendant son résultat. Pour un agent réalisant plusieurs opérations indépendantes, cette attente peut devenir un gaspillage important. Le guide recommande d'exploiter les appels d'outils asynchrones lorsque l'environnement les prend en charge. L'agent peut alors poursuivre certaines analyses ou effectuer d'autres opérations pendant qu'un outil externe travaille. Il doit toutefois attendre le résultat avant de commencer une étape qui en dépend. Cette dernière précision est essentielle. L'exécution asynchrone ne doit pas conduire à utiliser des informations qui n'ont pas encore été obtenues ni à considérer comme réussie une opération toujours en cours. OpenAI présente également le mid-turn steering, qui permet de transmettre de nouvelles instructions pendant un travail prolongé. Un développeur peut ainsi corriger une contrainte, modifier un objectif ou apporter une précision sans nécessairement relancer toute la tâche depuis le début. Le mécanisme ne signifie pas que les actions déjà effectuées sont automatiquement annulées. La correction doit tenir compte de l'état réel du travail et des conséquences des opérations précédentes.
La délégation entre agents promet davantage de parallélisme
GPT-6.1 Sol prend en charge des mécanismes de délégation entre agents dans les environnements API appropriés. L'idée consiste à répartir certaines sous-tâches entre plusieurs agents spécialisés. Sur un projet logiciel, un système pourrait demander à un agent d'examiner les tests existants pendant qu'un autre analyse une partie différente du code. Les résultats peuvent ensuite être réunis pour poursuivre le travail. Ce fonctionnement rappelle une organisation en équipe, avec des tâches séparées et des responsabilités explicites. Il ne signifie pas que plusieurs agents travaillant simultanément produiront nécessairement de meilleurs résultats. Les problèmes de coordination, les duplications de travail et les incohérences entre conclusions peuvent diminuer les bénéfices. Le guide recommande de privilégier les opérations réellement indépendantes et de conserver des mécanismes de synthèse et de vérification. La délégation mentionnée reste en bêta dans certains environnements. Elle doit donc être distinguée des fonctionnalités déjà stabilisées et disponibles pour tous les usages.
Computer use : agir sur les logiciels qui n'ont pas d'API
OpenAI évoque également les capacités de computer use, destinées aux situations dans lesquelles un modèle doit manipuler une interface graphique. Un agent peut avoir besoin de consulter un site, cliquer sur des éléments ou remplir un formulaire dans une application qui ne dispose pas d'interface de programmation directement exploitable. Le guide recommande toutefois de choisir d'abord la solution technique la plus simple et la plus fiable. Si une API permet de réaliser une opération, elle constitue généralement une option plus directe qu'une série de clics simulés. Computer use devient pertinent lorsque l'agent doit réellement passer par une interface visuelle. Cette capacité ne fait pas disparaître les risques liés aux opérations informatiques. Une interface peut changer, un bouton peut être mal identifié ou une action peut produire un effet différent de celui attendu. Le contrôle des permissions, la validation des résultats et l'encadrement des opérations sensibles restent indispensables. OpenAI cite notamment Playwright et PyAutoGUI comme outils pouvant intervenir dans ce type d'environnement. Le choix concret dépend du logiciel utilisé, du système d'exploitation et des possibilités de contrôle offertes à l'agent.
Une application doit être évaluée avant de passer en production
La dernière leçon du guide concerne la différence entre une démonstration impressionnante et un service fiable. Un prototype peut réussir quelques scénarios choisis et donner l'impression que le système fonctionne parfaitement. Une application réelle rencontrera pourtant des données différentes, des erreurs réseau, des outils indisponibles et des demandes difficiles à anticiper. OpenAI recommande donc de construire des évaluations représentatives des usages attendus. Il faut examiner les réussites, mais aussi les échecs, le temps d'exécution et les coûts associés. Les questions de surveillance et de gestion des données doivent être traitées avant un déploiement à grande échelle. Un agent capable de modifier un environnement informatique doit également pouvoir rendre ses opérations vérifiables. Ces principes ne garantissent pas l'absence de panne. Ils permettent de transformer un système expérimental en produit dont les limites sont mieux connues et dont le fonctionnement peut être contrôlé.
Le prix d'un modèle ne dit plus grand-chose sans son usage
Le guide du 2 octobre montre une évolution importante dans la manière dont OpenAI présente sa technologie. La compétition ne se limite plus à produire un modèle capable d'obtenir de meilleurs résultats que le précédent sur des benchmarks. Pour les développeurs, la difficulté est devenue plus concrète : choisir le niveau de capacité nécessaire, exploiter efficacement les ressources et construire une application qui reste fiable lorsqu'elle fonctionne en continu. Astra, Sol et Luna répondent à des besoins différents. La hiérarchie tarifaire est spectaculaire, mais elle ne doit pas masquer les coûts des outils, des reprises, du raisonnement ou des traitements accélérés. Le conseil le plus utile du document est probablement le moins spectaculaire : mesurer ce qui fonctionne réellement. Un modèle moins cher peut constituer le meilleur choix si ses réponses satisfont les critères de qualité. Un modèle plus coûteux peut être préférable lorsqu'il évite plusieurs échecs ou remplace une chaîne de traitement complexe. Le véritable progrès ne consiste donc pas à utiliser GPT-6 partout. Il consiste à savoir quand utiliser chaque modèle, quelles décisions lui confier et comment vérifier qu'il a correctement accompli son travail.