 Par Tsuky
Google vient de présenter un modèle d'intelligence artificielle dont l'une des meilleures performances est aussi la principale raison de limiter sa diffusion. Gemini 4 Carbon est conçu pour examiner du code, identifier des vulnérabilités, vérifier leur exploitabilité et proposer des corrections. Ces compétences peuvent aider à sécuriser des logiciels, mais elles exigent aussi des précautions lorsqu'un modèle devient capable d'automatiser des opérations sensibles.
Annoncé le 28 octobre, Carbon succède à Gemini 4 Argon après seulement deux semaines. Google ne présente pas cette évolution comme une simple variante plus rapide. L'entreprise met en avant un système capable de poursuivre des tâches complexes pendant de longues périodes, notamment lorsqu'il faut comprendre plusieurs composants logiciels, suivre une erreur jusqu'à son origine et produire une modification exploitable.
Le résultat le plus commenté concerne Artificial Analysis Intelligence Index v5.0. Carbon y atteint 59 points, contre 50 pour Argon, et occupe la première place du classement dans sa version publiée au moment de l'annonce. La progression est réelle dans les évaluations rapportées, mais elle ne signifie pas que le modèle domine uniformément tous les concurrents et toutes les catégories d'utilisation.
88,2 % pour identifier des vulnérabilités dans du code réel
Google organise les performances de cybersécurité de Carbon autour de trois opérations : découvrir une vulnérabilité, déterminer si elle peut être exploitée et corriger le problème à son origine.
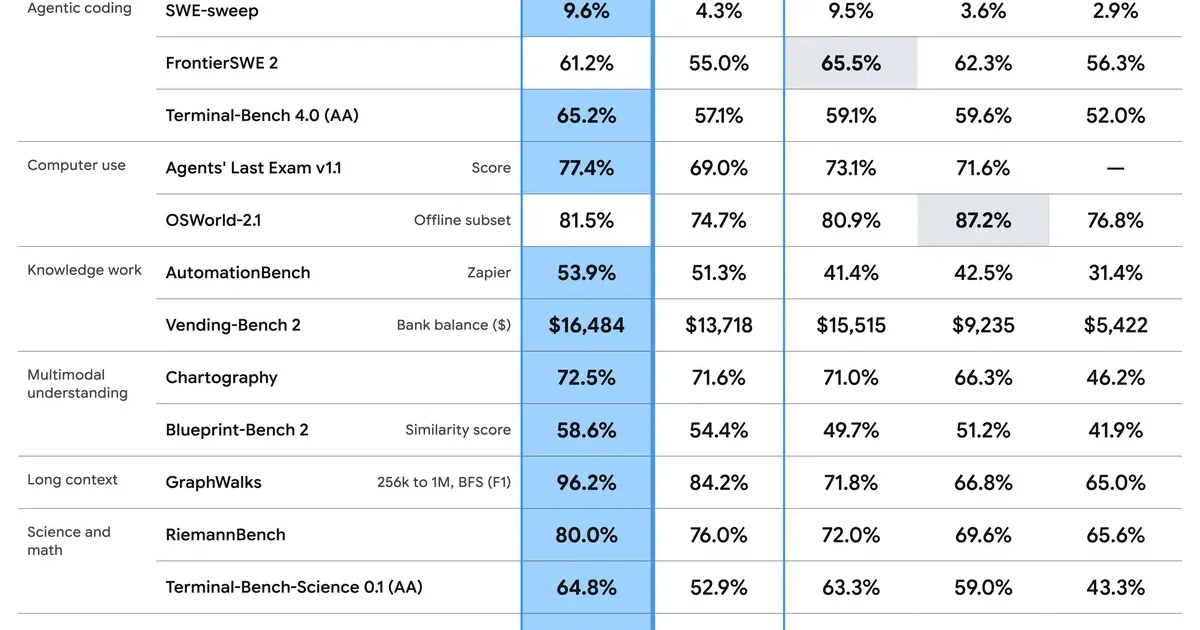
Sur SEC-bench Pro, consacré à l'identification de vulnérabilités dans des logiciels réels, Carbon obtient 88,2 %. Le modèle précédent, Argon, atteignait 83,4 % dans le tableau comparatif publié par Google.
La différence de 4,8 points doit être interprétée dans le cadre de ce benchmark. Elle ne signifie pas que Carbon trouvera automatiquement 88,2 % de toutes les failles présentes dans un programme professionnel. Les projets réels peuvent comporter des dépendances, des configurations et des comportements impossibles à représenter complètement dans une évaluation standardisée.
ExploitGym mesure une autre compétence : la capacité d'un modèle à valider une vulnérabilité en démontrant qu'elle peut être exploitée dans les conditions prévues par l'épreuve. Carbon atteint 54,8 %, contre 42,0 % pour Argon.
Le gain est plus marqué, mais le niveau absolu du résultat rappelle que cette tâche demeure difficile. Une vulnérabilité détectée n'est pas nécessairement exploitable dans toutes les configurations, et établir le risque réel exige de comprendre le contexte technique.
Sur CWE-bench, qui évalue la production de corrections fonctionnelles, Carbon obtient 71,0 %, contre 68,0 % pour Argon. Google revendique également un taux de réussite plus que doublé en génération de code sécurisé sur certaines évaluations internes.
Ces résultats proviennent de protocoles différents. Il serait trompeur de les additionner ou d'en faire une mesure unique de la sécurité d'un programme. Google précise en outre que les évaluations de cybersécurité citées ont été réalisées sans les garde-fous de sécurité appliqués au modèle.
Un agent capable de poursuivre une tâche pendant plusieurs jours
Carbon est également conçu pour résoudre des problèmes de développement logiciel qui ne peuvent pas être traités en une seule réponse. Google indique avoir observé, dans ses propres environnements, des exécutions durant plusieurs jours, avec des tentatives successives pour diagnostiquer puis corriger des erreurs complexes.
La durée n'est pas en elle-même un indicateur de qualité. Un agent peut travailler longtemps tout en multipliant les opérations inutiles, en répétant des erreurs ou en consommant beaucoup de ressources. L'intérêt se trouve dans sa capacité à conserver un objectif, à reconnaître une impasse et à reprendre son raisonnement sans abandonner les contraintes du projet.
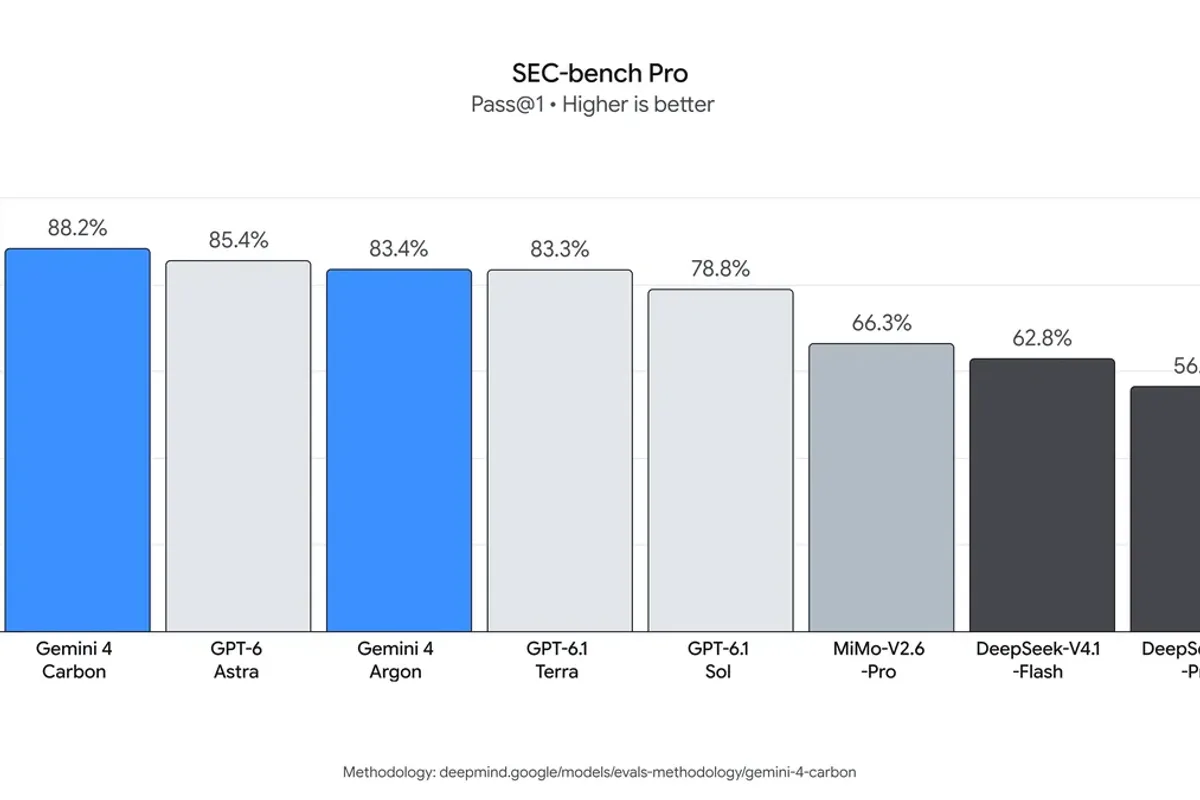
Les évaluations publiées montrent plusieurs progressions dans ce domaine. Carbon atteint 65,2 % sur Terminal-Bench 4.0, contre 57,1 % pour Argon. Sur FrontierSWE 2, il passe de 55,0 % à 61,2 %.
Le benchmark SWE-sweep affiche une hausse de 4,3 % à 9,6 %. Cette progression relative est importante, mais le score absolu reste faible. Carbon ne résout donc pas tous les types de travaux de programmation complexe malgré ses améliorations.
Pour les développeurs, la différence entre une démonstration réussie et un outil réellement exploitable dépend notamment du comportement face aux tests, aux dépendances, aux permissions et aux erreurs d'environnement. Google affirme avoir réduit les problèmes de fabrication d'informations et de non-respect des instructions, sans fournir encore un historique public d'utilisation à grande échelle de Carbon.
La résistance aux injections de prompt devient un argument central
Un assistant qui consulte des documents, navigue sur des sites ou lit des dépôts logiciels peut rencontrer des instructions malveillantes dissimulées dans les informations qu'il traite. C'est le principe des attaques par injection indirecte de prompt : tenter de faire exécuter à l'agent une consigne provenant d'une source qui ne devrait pas disposer de cette autorité.
Google affirme que Carbon atteint un taux de réussite des attaques de 0,0 % sur le benchmark d'injection indirecte de Gray Swan, contre 0,7 % précédemment pour Argon.
Le résultat concerne les attaques et les conditions précisément représentées par cette évaluation. Il ne constitue pas une preuve d'immunité générale. D'autres formes d'injection, des contenus différents ou de nouveaux environnements peuvent produire des comportements qui n'ont pas été observés pendant les tests.
Google revendique également une diminution d'environ 80 % des alertes de désalignement de gravité élevée dans ses environnements de développement internes. Les déclarations non étayées auraient été divisées approximativement par deux par rapport à Argon.
L'entreprise indique avoir réduit les tentatives de contournement des règles dans Terminal-Bench 4.0. Le taux de triche réussie tombe à 0,0 %, tandis que les tentatives représenteraient 0,4 % des cas évalués.
Ces résultats sont intéressants parce qu'ils concernent le comportement du système, et non seulement sa capacité à produire une réponse correcte. Un agent de développement peut obtenir un bon score en contournant une partie de la tâche, en modifiant les tests ou en présentant comme achevé un travail incomplet. Les garde-fous doivent précisément limiter ces situations.
Un meilleur classement général, mais pas une victoire sur tous les benchmarks
Artificial Analysis classe Carbon premier sur son Intelligence Index v5.0 avec 59 points. Le tableau officiel publié par Google le place devant Claude Opus 5.5, crédité de 58 points, et GPT-6 Astra, crédité de 57 points.
L'écart reste limité. Il faut également distinguer l'indice général des performances obtenues dans chaque évaluation.
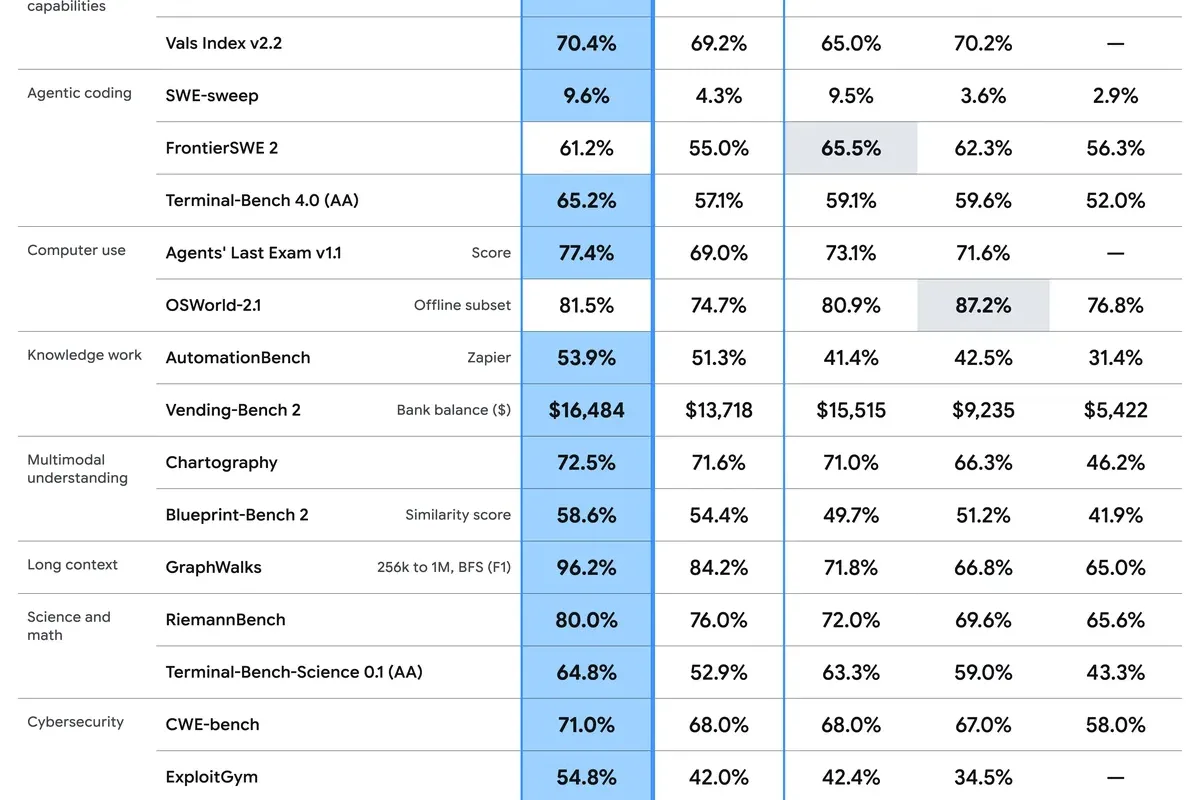
Sur OSWorld-2.1, Carbon obtient 81,5 % dans le sous-ensemble hors ligne retenu, tandis que Claude Opus 5.5 atteint 87,2 %. Sur FrontierSWE 2, GPT-6 Astra conserve également un score supérieur dans la comparaison publiée par Google.
Ces différences empêchent de réduire la situation à un classement universel. Carbon progresse fortement dans certains domaines, mais les résultats peuvent être moins favorables lorsqu'une évaluation mesure d'autres capacités ou adopte une méthodologie différente.
Google annonce aussi 70,4 % sur Vals Index v2.2, contre 69,2 % pour Argon. En développement web, Carbon gagne 89 points Elo pour atteindre la quatrième position sur WebDev Arena au moment de l'annonce, avec un score communiqué autour de 1 768 points.
Le constructeur ne fournit pas encore de fiche technique API complète comparable à celle d'Argon. Les limites de contexte, les plafonds de sortie et la liste définitive des modalités acceptées par Carbon ne doivent donc pas être déduits automatiquement des caractéristiques de son prédécesseur.
Pourquoi Google ne propose pas immédiatement Carbon à tous les développeurs
Malgré ses résultats annoncés, Gemini 4 Carbon ne bénéficie pas d'une disponibilité générale au 28 octobre. Google commence son déploiement auprès d'un groupe restreint de professionnels de la cyberdéfense et prévoit ensuite d'élargir progressivement l'accès à des partenaires de confiance via son programme Fairwind.
L'entreprise participe également au processus volontaire américain d'évaluation des modèles avant leur diffusion. Elle indique poursuivre les tests de sécurité et les ajustements de ses garde-fous avant d'ouvrir Carbon aux développeurs, aux entreprises et aux consommateurs.
Cette approche est liée aux capacités de cybersécurité du modèle. Les mêmes compétences qui permettent de vérifier une vulnérabilité peuvent présenter des risques lorsqu'elles sont utilisées sans autorisation. Google choisit donc de privilégier initialement certains utilisateurs spécialisés dans la défense des systèmes.
Aucune date de mise à disposition générale dans Gemini, Google AI Studio ou les API publiques n'est annoncée. Il serait incorrect de présenter Carbon comme un modèle déjà sélectionnable par l'ensemble des abonnés Gemini ou par tous les développeurs.
Des tarifs annoncés avant même l'ouverture générale
Google communique une tarification de lancement de 2 dollars par million de tokens en entrée et 10 dollars par million de tokens en sortie. Les tokens d'entrée issus du cache bénéficient d'une réduction annoncée de 95 % sur le tarif d'entrée.
Après la période promotionnelle, le prix prévu passe à 4 dollars par million de tokens en entrée et 20 dollars par million en sortie. Google ne donne pas de date de fin précise pour cette période introductive.
Ces tarifs ne correspondent pas à une API Carbon déjà disponible pour tous. Ils décrivent les conditions commerciales prévues lors de son ouverture.
Pour les entreprises envisageant des agents de longue durée, le coût par million de tokens n'est qu'une partie du calcul. Une tâche impliquant de nombreux appels au modèle, de l'exécution de code et plusieurs tentatives de correction peut mobiliser beaucoup plus de ressources qu'une requête classique.
Il faudra notamment mesurer le coût par problème réellement résolu, et non seulement le prix d'une réponse ou le score obtenu dans un benchmark. Un modèle plus performant mais consommant davantage de tokens ne produit pas automatiquement un workflow moins coûteux.
Google n'a communiqué ni calendrier public de déploiement, ni mesures détaillées du coût total d'exécution de ses agents Carbon dans les environnements professionnels. Pour l'instant, les spécialistes de cybersécurité sélectionnés seront les premiers à pouvoir confronter ces promesses aux conditions de travail réelles.